Thursday, February 16, 2012

Empacar datos ( Mucho mas que cintas, moños, cajas y plastico)

En este artículo describiremos algunos de los conceptos clave relacionados con el empaquetamiento de datos, incluyendo bits, bytes, paquetes, la encapsulación de datos y su interpretación por parte de las capas del modelo TCP/IP.

Para empezar definiremos que es un Host, este es un término genérico que puede hacer referencia a una estación de trabajo, un router o un servidor web, por citar sólo algunos ejemplos. Los hosts están conectados a una red que capaz de transportar datos desde, hacia y a través de ellos.

Los datos intercambiados entre dos hosts deben ser agrupados en paquetes usando un formato estándar. La confusión surge porque dichos paquete de datos tienen diferentes nombres en las distintas capas de comunicación, desde la capa de aplicación del dispositivo de  origen a la capa aplicación del dispositivo de destino.


Bits, bytes y paquetes

La unidad mas pequeña e indivisible de la computación es el bit, algo así como el átomo de la informática. Un bit es un simple espacio de almacenamiento que puede tener unicamente el valor 0 o 1, así que usaremos lenguaje binario.

Aunque breve y compacto, la realidad es que no es posible almacenar o transmitir una gran cantidad de información con un solo bit, así que es mejor agrupar los bits en grupos de ocho. La unidad de ocho bits se denomina byte (octeto). Ocho veces una cantidad muy pequeña de información es todavía muy pequeño, sin embargo un byte puede contener un carácter ya sea una letra (a), un símbolo coma(,)  o un número entero entre 1 y 255 (2^8-1). Esto lo determina el Código del Estándar Americano para Intercambio de Información (-ASCII- American Standard Code for Information Interchange).


La posición de cada bit se representa en base binaria y se expande como potencia de 2 desde 2^0 a 2^7. Si todos los bits tienen un valor 0, el byte completo representa un 0. Ahora si todos los bits son 1s (como en nuestra tabla). Es necesario sumar todos los valores de los bits individuales, empezando por el menor valor (2^0 = 1, cualquier base con exponente 0 es igual a 1), así 1 + 2 + 4 + 8 + 16 + 32 + 64 + 128 = 255, este es el máximo valor que un byte puede tener y lo aplicaremos con frecuencia al hablar de direcciones IP.

Cuando obtenemos un byte de datos, debemos convertir su valor en binario a su valor decimal correspondiente. La posición de cada bit asigna el valor decimal que lo acompaña. Entonces, sumamos todos los valores decimales, y listo, la conversión se realiza, después de todo no es tan difícil ¿verdad?.

El empaquetamiento y envío de datos a través de la red genera altos costos operativos para el host de origen, adicionalmente los paquetes deben desempacarse cuando llegan al host de destino, el cual verifica el sello que garantiza que los datos no han sido modificados (Tamper proof seal), este es el campo de verificación de redundancia cíclica (CRC -cyclical redundancy check), el cual valida que la trama (frame: nombre del paquete enviado por la capa física) no ha sido dañada o corrompida durante el transporte.

Análogamente con un oficina de correo tradicional, los sobres de las cartas indican la dirección de correo donde deben entregarse, los paquetes IP incluyen la dirección de envío y recepción del host. Podemos pensar en la dirección de control de acceso al medio MAC (Media Access Control) de la tarjeta de interfaz de red como la dirección asignada a la puerta de una casa.

En Redes, al menos en redes Ethernet,  la tarjeta de interfaz de red o NIC (Network interface card) contiene la dirección de hardware MAC; la cual es asignada por el fabricante al construir la tarjeta. La dirección MAC es de 48 bits, lo que significa que puede contener un número muy grande (2^48-1). Más adelante analizaremos las diferencias entre las direcciones MAC e IP.

Para crear una trama o frame, que es el nombre que el paquete adquiere cuando se transmite por el medio físico, el paquete se construye con varias capas de protocolo, Por ultimo la tarjeta NIC incluye su dirección física (MAC) y pone la trama en el medio de transmisión de la red. La trama tiene una cabecera de 14 bytes, y sus campos incluyen: datos propios de la trama que pueden variar en longitud, la dirección MAC del origen y destino, ademas de un espacio de 4 bytes que representa el CRC.

Las aplicaciones como Telnet, FTP o un cliente de correo electrónico, cargan los datos en paquetes, las aplicaciones TCP las discutiremos mas detalladamente en la sección Protocolos IP. El paquete TCP tiene dos segmentos, el encabezado y los datos.
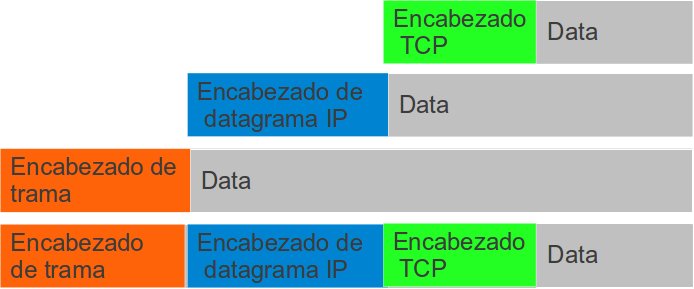

Un segmento TCP se transmite desde la capa TCP a la capa IP del modelo TCP/IP. La capa IP añade su cabecera en la parte delantera del segmento TCP recibido, asi se convierte en un datagrama IP. En realidad, la cabecera TCP y el contenido interno se ven como datos del datagrama IP, el cual tiene su propio encabezado. El datagrama IP es enviado a la capa de enlace de la pila TCP/IP, y es conocido como trama. La capa de enlace antepone el encabezado a la trama a los datagramas IP para llevarlo a través del medio físico, por ejemplo Ethernet.

La cabecera de una capa hace parte de los datos en la siguiente capa. En el ámbito UDP, el paquete es llamado datagrama. No confundirlo con el datagrama TCP cuyo nombre similar describe al paquete de la capa IP.

El proceso se repite inversamente cuando la trama llega al host de destino y todos los encabezados son removidos al pasar por los respectivos protocolos de capa superior. Cada capa de la pila TCP/IP incluye mensajes para comunicarse con la capa similar de host de recepción.

Interpretación del encabezado

Cuando se ejecutan todas las capas en un paquete, este se ve como un gran conjunto de 0s y 1s adyacentes. ¿Cómo interpretarlo? Suponiendo que estamos buscando la cabecera IP. ¿Cómo saber qué tipo de protocolos se han incluido? Sin duda necesitamos conocer el protocolo para poder interpretar el paquete adecuadamente. El término "Protocolo" se usa para designar un conjunto de acuerdos entre reglas o formatos. Cada protocolo (IP, TCP, UDP, e ICMP) tiene sus propias formas de comunicación y formatos.


La figura anterior muestra un ejemplo de la estructura del encabezado IP, el cual asigna un número de bits a cada campo. El campo de protocolo identifica el protocolo embebido(incorporado). Cada fila que se ve en la cabecera IP es de 32 bits (de 0 a 31), es decir, cuatro bytes.

Para complicar las cosas un poco, empezaremos a contar las posiciones de los bytes desde 0. La primera fila representa los bytes 0 a 3, la segunda fila representa los bytes de 4 a 7, y la tercera fila representa bytes de 8 a 11. Observe el circulo en el campo Protocolo que está en la tercera fila. El campo anterior tiempo de vida (TTL -TimeToLive) es un octeto de 1 byte de longitud en el octavo byte, y el campo de Protocolo, que también tiene una longitud de 1 byte, representa el noveno byte. Esto significa que el noveno byte (en realidad, es el byte 10,  recuerde comenzar a contar desde 0) indica el protocolo incluido. El punto es que la mayoría de los paquetes en sus respectivos niveles son posiciónales, los campos son identificados al conocer su ubicación en el paquete.

Ahora que hemos contado el camino hasta el campo Protocolo, su valor nos indica qué protocolo se encuentra en los datos adjuntos. Suponiendo que el valor encontrado en este byte es 17 en decimal,  el cual representado en hexadecimal es 11. Esto significa que después de la cabecera IP hay un paquete UDP. El valor 6 significa que hay un paquete TCP y el valor 1 significa que es un Protocolo de Mensajes de Control de Internet (ICMP -Internet Control Message Protocol).

Base 16 Hexadecimal

Hemos aprendido que un número binario tiene una base 2 y se compone de 0s y 1s. Este es el sistema de numeración que utilizan los computadores para representar los datos. ¿Por qué complicar el asunto con otro sistema nuevo de numeración en base 16 (o hexadecimal)? El dilema es que se necesitan muchos bits para representar cualquier número grande, por lo tanto, el manejar tanta información binarios puede complicarnos la vida fácilmente. La notación Hexadecimal abrevia los números binarios. 4 bits binarios se pueden sustituir un carácter hexadecimal (2^4 = 16).

Consideremos por ejemplo, el campo de cabecera del protocolo IP que es de 8 bits. Este se puede convertir en 2 caracteres hexadecimales. El decimal 17 en el campo de protocolo, significa que el protocolo incluido es UDP. ¿Cómo convertir el decimal 17 a el hexadecimal 11?


Aquí tenemos las potencias binarias de un byte. Para representar el decimal 17, es necesario tener el bit correspondiente a 16 (2^4) en 1, y el bit (2^0) en 1, es decir, 16 + 1 = 17. Estos han sido agrupados en dos dígitos hexadecimales, dos grupos de 4 bits o caracter hexadecimal. Los 4 bits de la izquierda (también conocidos como de orden superior o bits más significativos) tienen el valor 0001. Del mismo modo, los 4 bits más a la derecha (también conocidos como de orden inferior o bits menos significativos) tienen un valor de 0001. Cada carácter representa valores hexadecimales de 0 a 15. Cada uno tiene un bit menos significativo de valor 1 en 2^0, por lo que el valor hexadecimal es 11 (también conocido como 0x11, donde 0x lo identifica como hexadecimal.

Si tienes información adicional sobre este tema, tus comentarios o links de referencia son bienvenidos. 

Monday, February 06, 2012

Clasificación de datos en un sistema de gestión de seguridad de la Información


Paso 1: Establecer las clases de seguridad 
Un ejemplo es la clasificación de confidencialidad de acuerdo a InfoSiG (Limitada, confidencial, secreto, Top secret). También existen clasificaciones según su propia definición:
  • ABIERTO: La información que ha sido expresamente aprobada para su publicación (por ejemplo, leyes, Reglamento, comunicados de prensa, publicaciones, folletos promociónales, página web)
  • CONFIDENCIAL: Información para el uso interno de la empresa y no existe  la intención de su publicación (por ejemplo, la correspondencia interna, directorios telefónicos internos , organigramas)
  • SECRETO: La información cuya utilización indebida de la organización pueda causar daños significativos. (Por ejemplo, datos sobre ofertas, costos internos, planificación estratégica, ...)
La Disponibilidad de Sistemas y Aplicaciones también se pueden clasificar  en diferentes categorías según sus esquemas de operación 
  1. Sin Precaución:  La falta de acceso por  un período indefinido no afectará el desempeño de las operaciones fundamentales (no crítico) 
  2. Aseguramiento cuando no hay conexión: Medidas de seguridad, servicios contratados externamente, Reinicio de la aplicación después de la reparación de los daños del sistema original.
  3. Infraestructura redundante:  En el caso de que un dispositivo falle hay continuidad del servicio o la operación sin interrupción.
  4. Redundancia en el lugar de Ubicación: redundancia de la infraestructura, sistemas y aplicaciones para reanudar el funcionamiento total en caso de una interrupción
Paso 2: Definir las responsabilidades y Métodos
  • ¿Quién es responsable de la clasificación?
  • ¿Cuáles son los criterios para clasificar?
  • ¿Cuándo y por quién van a ser desclasificados los datos?
Paso 3: Reglas para tratar Información clasificada
  • Identificación de la información clasificada (electrónica o no electrónica) 
  • Almacenamiento de información clasificada ( Permisos de acceso y algunos  requisitos para aplicar Criptografía)
  • Transmisión de información clasificada (Sobre que canales de comunicación,   las reglas de cifrado)
  • Forma en que se presenta la información clasificada (Archivos de solo lectura, permisos de modificación o impresión, a quien se le conceden tales permisos y a quien se le restringen)
  • Copia de seguridad (texto, cifrados, la protección de los dispositivos donde se almacenan las copias de seguridad)
  • Almacenamiento / recuperación / destrucción de los discos con información clasificada
  • Divulgación de información clasificada (de quién, por quién, en qué condiciones) 
  • Desclasificación de la información clasificada (cuándo, por quién)

Si tienes información adicional sobre este tema, tus comentarios o links de referencia son bienvenidos. 

Personal Técnico y roles relacionados con seguridad de la información


Jefe de Seguridad TI: Técnicamente posee toda la responsabilidad sobre todos los problemas de seguridad IT o de la información dentro de una organización.
  • Participación responsable en la creación del concepto de seguridad de la información dentro de la organización.
  • Responsabilidad general de la aplicación de las medidas de seguridad
  • Planificación y coordinación de eventos de capacitación y sensibilización
  • Garantizar la seguridad de la información en las actividades operativas
  • Gestión de los recursos de seguridad de la información disponibles
Grupo de Administración de Seguridad: Equipo responsable de la regulación de las cuestiones de seguridad en toda la organización, así como de la preparación de los planes, especificaciones y directrices para la seguridad TI y de la información.
  • Establecimiento de objetivos de seguridad de la organización.
  • Desarrollo de una política de seguridad de la información en toda la organización.
  • Apoyo y asesoramiento en la elaboración del concepto de seguridad de la
    Información.
  • Promover la concientización sobre la seguridad en toda la organización.
  • Definición de los recursos humanos y financieros para la seguridad de la información.
Área encargada de la seguridad IT: La responsabilidad técnica de todos los asuntos de seguridad en un área determinada (Sistema IT, plataforma de sistema operativo, lugar de funcionamiento, ...)
  • Participación de las partes pertinentes de su gama Información del concepto de seguridad
  • Desarrollo de un plan detallado para implementar las medidas de seguridad seleccionadas
  • Implementación del plan de implementación 
  • Revisión periódica de la efectividad y el cumplimiento de las Las medidas de seguridad establecidas para ser ejecutadas en la operación
  • Informar al Jefe de seguridad sobre las necesidades de capacitación en el área específica 
  • Informar al Jefe de seguridad sobre los eventos relevantes de seguridad
Administrador del proyecto o de la aplicación: "Dueño y señor del Sistema" responsable de todos los asuntos de seguridad de una aplicación o  proyecto IT. 
  • Determinación de los requisitos de seguridad y calidad
  • Clasificaciones de los datos procesados
  • Asignación de derechos de acceso
  • Garantizar las medidas organizativas y administrativas de seguridad en el desarrollo de proyectos y operaciones en curso.
Encargado de Seguridad de la Información: Leyes de Seguridad de la Información deben ser establecidas a nivel de gobierno.
  • Vigilar el cumplimiento de las disposiciones emitidas por el grupo de gestión de seguridad de la información.
  • Revisión periódica de las medidas de seguridad para la protección de la  información clasificada.
  • Presentación de informes a la Comisión de Seguridad de la Información
  • Corrección de las deficiencias detectadas.
  • Encargado de la seguridad de la información de Gobierno y ministerios.
  • Revisión de las sugerencias a mejorar en el caso que sea necesario.
Empleados y usuarios: Tienen la responsabilidad de seguir las políticas de seguridad en su puesto de trabajo y al usar los recursos de IT (Computadores, portátiles, impresoras ...).
  • Cumplimiento de las políticas de seguridad
  • Uso responsable de del ID de usuario, contraseñas, claves de cifrado,  control de acceso ya sean llaves o tarjetas inteligentes
  • Uso consciente y responsable de los derechos de acceso, los cuales solo pueden ser utilizados para realización las tareas relacionadas con sus funciones laborales) 
  • Notificación de la percepción de problemas de seguridad, ya sean eventos o usuario sospechosos. 
  • El empleado debe obtener instrucciones precisas en cuanto al cumplimiento de sus obligaciones en relación con la seguridad de la información. 
Otros roles

  • Administradores
  • Desarrollo y soporte técnico 
  • Personal temporal, empleados externos 
  • Proveedores y contratistas,
  • Auditores y revisores.

Si tienes información adicional sobre este tema, tus comentarios o links de referencia son bienvenidos. 

Manual de seguridad de la información

Los siguientes conceptos han sido obtenidos de los manuales de de la Oficina federal alemana para la seguridad y las tecnologías de la información, abreviada como BSI (Bundesamt für Sicherheit in der Informationstechnik)

Definición y tareas de gestión de seguridad


  • Seguridad IT: Es el estado de un sistema de información donde es posible limitar los riesgos y amenazas un nivel controlable. Esto es gracias a la implementación de medidas adecuadas que se han tomado para proteger la infraestructura tecnológica y de información. 
  • Seguridad TIC: Seguridad para los sistemas IT y de comunicación
  • Seguridad de la Información: Protege la información contra pérdida, alteración y acceso no autorizado. Incluye los activos de información que se ha procesado y almacenado electrónicamente, además de la información verbal o escrita en documentos (SIHB).
  • Privacidad: Protección de datos personales (DSG)
  • Seguridad de datos: (GDG) depende del tipo de datos utilizados, el alcance y el propósito de uso de estos. Es necesario tener en cuenta la capacidad técnica y la viabilidad económica para garantizar  el uso correcto de los datos y su  protección en contra de perdida, ya sea por destrucción accidental o ilegal, por ejemplo que no sean accesibles a personas no autorizadas. 
  • Gestión de Seguridad: Es el proceso continuo para garantizar el cumplimiento de los objetivos de seguridad (Confidencialidad, integridad, disponibilidad) de los sistemas IT. Los posibles requisitos adicionales son poder determinar la traceabilidad, responsabilidad, autenticidad y anonimato. 
Las nuevas tecnologías traen grandes ventajas pero también generan nuevos riesgos y nuevas amenazas.

¿Como está la situación hoy en día? 

  • Demasiadas medidas
  • Responsabilidades poco claras
  • Normas que se contradicen
  • Medidas poco prácticas
la seguridad de la información es siempre una tareas de administración y persigue los siguientes objetivos y funciones:
  • Definir los objetivos y las políticas de seguridad de la información que debe seguir una Organización
  • Identificación y análisis de riesgos
  • Establecimiento de medidas de seguridad adecuadas
  • Control de la ejecución y la operación continua
  • Fomentar la concientización sobre la importancia de las aplicación de las medidas de seguridad dentro de la empresa.
  • Generar respuestas adecuadas a los posibles incidentes de seguridad

Manual de seguridad de información SIHB

Recopila las medidas de seguridad estandarizadas para cumplir necesidades normales de protección, partiendo de diferentes fuentes como: el  Manual de Protección de Línea Base del  BSI  y de las normas ISO/IEC 27002, ISO/IEC 27001 e ISO/IEC TR 13335. Sus requisitos son:

• Compatibilidad con otros sistemas de gestión de seguridad
•
Acomodación al Marco legal y jurídico con las Normas y leyes del país dende se implemente
• Las medidas genéricas sin detalles específicos para un sistema en particular
• El sistema y la información poseen un Ciclo de vida el cual debe realimentarse, ajustarse y actualizarse, según la dinámica en que se mueva la organización.

Estructura del Manual

Capítulo 1: Introducción
Capítulo 2: Sistema de Gestión de Seguridad de la Información
Capítulo 3: Responsabilidad de Gestión
Capítulo 4: Análisis de Riesgos

Medidas SIHB conforme a ISO/IEC 27001 e ISO/IEC 27002

Capítulo 5: Política de Seguridad de la Información
Capítulo 6: Organización
Capítulo 7: los activos y la clasificación de la información
Capítulo 8: Seguridad del personal
Capítulo 9: La seguridad física y ambiental
Capítulo 10: Gestión de la seguridad en las comunicaciones y operaciones
Capítulo 11: Control de acceso, sistemas de autenticación
Capítulo 12: Seguridad en el desarrollo, operación y mantenimiento
Capítulo 13: Manejo de Incidentes
Capítulo 14: Recuperación de Desastres y de Continuidad del Negocio
Capítulo 15: Cumplimiento de Seguridad

Anexos incluidos en el SIHB
  • Escenarios de seguridad
    • Seguridad Industrial
    • Seguridad y la doctrina de defensa
    • Gobierno electrónico
  • Tecnologías de Seguridad
    • Medidas criptográficas
    • Tunelamiento
    • Virtualización
  • Patrones de contratos, compromisos, documentación
  • Normas
  • Documentos de referencia
  •  Tablas de referencia
  • Decisiones de la Junta Directiva TIC y leyes
  • Direcciones
Mas información detallada sobre SIHB aqui
 
Si tienes información adicional sobre este tema, tus comentarios o links de referencia son bienvenidos. 

Saturday, February 04, 2012

¿Como saber si un producto IT o Software es seguro?

Existen tres manera de responder esta pregunta
  • Confiar ciegamente en las declaraciones de los fabricantes del sistema IT o software.
  • Hacer pruebas personalmente, esto generaría un gran esfuerzo si se hace manualmente, debido al tiempo requerido en recopilación de documentación técnica sobre las diferentes versiones del sistema, sus pautas de desarrollo  y posibles vulnerabilidades que se generan en cada una de las actualizaciones del sistema. Adicionalmente conocimiento avanzado en codificación,  debugging y seguridad.
  • Recurrir a una auditoría neutral encargada de evaluar y certificar el cumplimiento de los requisitos de seguridad que se han especificado previamente en normas internacionalmente estandarizadas. Los criterios de evaluación son objetivos, confiables  y de validez general.  
Criterio de Evaluación de Sistemas de computación confiables

En ingles: Trusted Computer System Evaluation Criteria(TCSEC 1983) es un estándar creado por el departamento de defensa de los  EE.UU. También es  conocido como el Libro Naranja de Seguridad.

Base de computación Confiable (Trusted Computing Base TCB): Comprende las partes relevantes relacionadas con la seguridad del sistema, contiene todos los elementos del sistema encargados de soportar las política de seguridad y el aislamiento de objetos (código y datos) en que se basa la protección.

Monitor de referencia: Refuerza las relaciones de acceso autorizado entre los sujetos y objetos de un sistema [Informe Anderson, 1972]
El monitor de referencia debe estar siempre activo, ser lo suficientemente liviano para permitir el uso de métodos formales para sus comprobaciones y por supuesto, estar lo suficientemente protegido en contra de interferencias externas, manipulaciones y falsificaciones.

Modelos Formales de Seguridad
El modelo más conocido se llama Bell-LaPadula (1976), el cual especifica dos tipos de actores. primero los Sujetos o entidades activas como los  usuarios, administradores, aplicaciones o procesos y segundo los Objetos que son entidades pasivas como datos, archivos,etc.Cada sujeto y objeto tiene asignado diferentes atributos de seguridad.
  • No-Read-Up: Propiedad de seguridad simple, implica que sujetos con bajo nivel de confianza no deben leer los objetos con clasificaciones superiores  (clasificación de objetos ≤  Autorización de Sujeto)
  • No-Write-down: Sujetos con clasificación alta no deben escribir sobre  archivos con niveles de confianza inferiores.

Clases funcionales en TCSEC


D: Protección mínima (No cumple los requisitos de evaluación)

C: Protección discrecional (Protección definida por el usuario DAC)

  • C1: Protección de Seguridad Discrecional
    • Identificación y autenticación de los usuarios
    • Concesión y verificación de los derechos de acceso individuales
    • Protege contra la lectura o  destrucción accidental de información
  • C2: Protección de acceso controlado
    • Control detallado de acceso discrecional
    • Procedimientos de inicio de sesión, pruebas y reprocesamiento
    • Ofrece protección contra ataques dirigidos
    • Permite el rastreo de actividades ilicitas
B: Protección Mandatoria (Protección basada en reglas MAC)
  • B1:Protección de Seguridad Etiquetada
    • Descripción informal del modelo de seguridad baasada en normas de control de acceso
    • Todos los sujetos y objetos deben ser controlados por una Base de Computación Confiable (TCB) proporcionada por medio de atributos, los cuales pueden ser de forma jerárquica.
    • Los axiomas Bell-LaPadula deben cumplirse.
  • B2: Protección Estructurada
    • TCB basado en modelos formales  de seguridad
    • Diferencia entre elementos de seguridad críticos y no críticos
    • Todos los sujetos y los objetos poseen atributos
    • Hace frente a problemas como el de canales encubiertos o  definición de  Ancho de banda máximo.
     
  • B3: Dominios de Seguridad
    • Monitor de referencia
    • Supervisión de los eventos críticos para la seguridad
    • Implementación de mecanismos de reinicio
A: Protección Verificada
  •  Técnicas formales  de las especificación de diseño y su verificación

Continuación> Criterios Comunes para la evaluación de la seguridad en tecnologías de la información CC 

Fuente: TCSE
https://www.bsi.bund.de/cln_156/DE/Themen/ZertifizierungundAnerkennung/zertifizierungundanerkennung_node.html

Si tienes información adicional sobre este tema, tus comentarios o enlaces de referencia son bienvenidos. 

Monday, October 17, 2011

Protocolo de redundancia en routers virtuales (VRRP Virtual Router Redundancy Protocol)


AcrónimoSignificadoFabricante
VRRPVirtual Router Redundancy ProtocolRFC 3768
XRRP Router Redundancy ProtocolHewlet Packard
HSRPHost Standby Router ProtocolRFC 2281 3/1998 CISCO

Algunas de las principales características en entornos distribuidos y redes LAN son La tolerancia a fallos y la redundancia, por lo tanto el desarrollo de nuevas  tecnologías LAN va dirigido a garantizar una alta disponibilidad de interconexión de los dispositivos de red. Por ejemplo: la capacidad de soportar fallos de una tarjetas de interfaz en un servidor de balanceo de carga, o la configuración redundante de las fuentes de alimentación de los switches en un backbone.
Gracias a VRRP estas mismas características pueden ser aplicadas a los switches y routers de capa 3 que han sido configurados estáticamente como puertas de entrada predeterminadas, evitando así cualquier punto de fallo que se pueda generar, especialmente por redundancia en la asignación manual de las direcciones IP fijas de la puerta de enlace predeterminada.

Funcionamiento 
El primer paso a seguir para enrutar datos entre dominios de red es determinar una puerta de enlace. Algunos sistemas utilizan protocolos dinámicos de descubrimiento de ruteo, tales como OSPF (Open shortest path first - Primero la ruta libre mas corta) o RIP (Routing Information Protocol - Protocolo de Enrutamiento de Información), para determinar su puerta de enlace predeterminada. Los protocolos OSPF y RIP han sido diseñados para evitar cualquier fallo que se pueda presentar al obtener un puerta de enlace óptima.
Sin embargo, muchos administradores de red prefieren configurar las puertas de enlace de forma estática, para así reducir la sobrecarga de procesamiento en los hosts. El riesgo de dicho procedimiento es que el router que sirve de puerta de enlace predeterminada se puede convertir en un punto único de fallo, lo cual puede significar una catástrofe para los hosts que basan sus conexiones en una sola puerta de enlace predeterminada para acceder a una WAN o a otros dominios LAN.
Diseñar una arquitectura eficiente de VRRP es la manera relativamente simple de evitar los fallos ya mencionados, aunque los protocolos dinámicos de descubrimiento de rutas son capaces de localizar una nueva puerta de enlace predeterminada, VRRP proporciona un sistema de tolerancia a fallos mas rápida y eficientemente.

Componentes
La asignación de puertas de enlace predeterminadas se consigue mediante la creación de los routers virtuales, un maestro y un router de reserva (backup), actuando como un grupo. VRRP combina conjuntos de routers en grupos lógicos  llamados routers virtuales(VR), los VR redundantes son identificados para cada grupo, los cuales comparten una sola puerta de enlace predeterminada para aumentar la disponibilidad y fiabilidad de los caminos enrutados, así es posible asignar los VR como puertas de entrada a los hosts clientes que solicitan una conexión a la red.
El router VRRP responsable de controlar las direcciones IP asociadas con un router virtual se llama Maestro, este es único en el grupo y se encarga de dirigir los paquetes entrantes a las direcciones IP internas requeridas.
A la puerta de enlace predeterminada del host participante se le asigna un router virtual en lugar de un router físico. El router físico que reenvía los paquetes en un momento dado se llama el router principal, en caso de que este falle, otro router físico de reserva es seleccionado automáticamente para reemplazarlo. Uno o más routers pueden ser reserva en una misma LAN o VPN.
El maestro comunica su estado a los dispositivos de reserva, Si el maestro no puede comunicar su estado, VRRP toma un router de reserva en orden de precedencia, así el router backup responde asumiendo el papel de maestro para  garantiza la comunicación entre todos los routers que tengan aplicaciones VRRP, que estén asociados con una ID de Router Virtual y que soporten redundancia de routers a través de un proceso de elección prioritaria entre ellos.


Características Adicionales
El envió de mensajes internos entre routers se hace por medio de paquetes multicast IPv4 e IPv6, ya que está diseñado para LANs multiacceso y multicast/broadcast (como ethernet), así la dirección de origen del paquete enviado es siempre la dirección IP de la interfaz de envío.
VRRP funciona ademas en aplicaciones de balanceo de carga ya que permite que un router actúe como un maestro para una subred IP y como router de reserva (backup) para otra subred que tiene su propio router maestro. Dos routers configurados de esta manera pueden compartir carga, ya que cada router actúa como una reserva redundante del otro.
VRRP proporciona información sobre el estado de un router, no las rutas procesadas e intercambiadas por ese router. por lo tanto no reemplaza a ningún protocolo de routing.
Cada instancia VRRP tiene alcance limitado, a una única subred. No anunciar las rutas más allá de la subred IP o ni afectan a la tabla de enrutamiento de ninguna manera, debido a que los paquetes son enviados con TTL = 255, en el caso que el router reciba un paquete con TTL mas pequeño, el paquete es descartado.

Si tienes información adicional sobre este tema, tus comentarios o links de referencia son bienvenidos. 

Modelo TCP/IP de Internet


Internet ofrece una gran cantidad de servicios a los cuales los usuarios de computadores personales se suelen conectar, los propósitos son diferentes y variados, ya sea consultar una página web alojada en un servidor remoto, visitar una cuenta de correo electrónico, descargar o compartir archivos, etc. Estos procesos que aparentemente parecen triviales e inmediatos en realidad requieren de protocolos específico y de una infraestructura que responde a las peticiones que los usuarios finales han solicitado.

Capas

La siguiente figura muestra el camino lógico de algunos de los protocolos que intervienen en las comunicaciones host a host o host a servidor. El proceso de descarga de una página web comienza en el cuadro de busqueda del Navegador o browser. Antes de que una petición para ver la información de una página web llegue al servidor web donde está se encuentra alojada, el host de origen debe encapsular la petición a través de diversos procesos, niveles y protocolos, así a su vez enviarla a través de la red. Cada capa representa un tramo en el camino lógico entre el computador que origina la petición hasta al servidor que aloja la página web y que recibirá el paquete encapsulado.
 
Después de que el host emisor empaqueta los de datos por medio de las diferentes capas, los datos son entregados al host receptor a través de Internet. El equipo receptor desenvuelve las capas de datos, una por una. Una capa individual obtiene los datos destinados para a ella y pasa el resto del mensaje a las capas superiores. Las siguientes cuatro capas componen el modelo TCP/IP de Internet:
  • Capa de aplicación. Es la capa superior (la solicitud de una página web en el ejemplo anterior). Contiene el Software de envío y recepción que soporta las aplicaciones implementadas como por ejemplo el navegador y el servidor web.
  • Capa de transporte. Debajo de la capa de aplicación está la capa de transporte. Esta capa abarca muchos aspectos de la forma en que dos hosts se comunican. Esta capa de transporte proporciona fiabilidad a otras capas inherentemente poco fiables.
    Los dos tipos de protocolos de transporte normalmente son: TCP, que asegura una entrega fiable de datos debido a sus mecanismos para garantizar la entrega de estos, mientras que el User Datagram Protocol (UDP), es un protcolo no orientado a la conexión lo que lo hace poco confiable por la perdida de datos que presenta. En este ejemplo de aplicación con el servidor web , TCP es necesaria debido a que no se admite la pérdida de datos.
  • Capa de red. Debajo de la capa de Transporte está la capa de red,la cual es responsable de mover los datos desde el equipo de origen hasta el equipo de destino (el servidor web, en este caso), a menudo hay saltos sobre algún tramo de la ruta de red. Este salto pude estar entre un host y un router, o entre dos routers, sin embargo en última instancia, se toman los datos del camino de enrutamiento mas cercanos para alcanzar su destino.
  • La capa de enlace. La capa inferior es la capa de enlace, esta capa se encarga de las comunicaciones desde un host al medio físico en el que reside. Puede ser ethernet, wireless o fibra óptica. Esta capa se ocupa de recibir y enviar datos desde el host a través de una interfaz específica a la red.

Flujo de Datos

Teniendo en cuenta la figura anterior, la actividad del flujo de datos sería la siguiente: La solicitud de una página web desde un host remitente, desciende las capas de la pila TCP/IP. Se dirige al equipo de destino por medio de la capa inferior o capa de enlace y sube nuevamente la pila TCP/IP del servidor. 
Las flechas horizontales entre los hosts representa la comunicación entre capas del mismo nivel. Los dos equipos no interactúan directamente entre sí, por sí mismos. Cuando la solicitud desciende la pila TCP/IP del computador que envía, los datos son  empaquetados de manera que cada capa tiene un mensaje para su capa contraparte, por lo que parecen estar hablando directamente.

los concepto mas importantes para comprender es el modelo de pila TCP/IP el cual se  se utiliza para describir la estructura en capas del procesamiento de solicitudes o respuestas TCP/IP. Esto significa que los datos en el host remitente se envuelven con las etiquetas de identificación de cada capa, para guiar al equipo receptor en el análisis del mensaje recibido, capa por capa. 
Cada capa del dispositivo que envía añade su propia cabecera, y el host receptor invierte el proceso para desempacar el mensaje, eliminando la cabecera, y dirigiendo el resto de datos a la capa correspondiente. Este proceso se repite desde la capas mas altas del servidor hasta que los datos llegan a la capa superior del host receptor, el cual finalmente procesa las solicitudes de la página web. Cuando la respuesta se envía de nuevo, todo el proceso se repite, ahora el equipo donde se aloja el servidor web empaqueta los datos a enviar, los cuales son entregados y recibidos, el equipo cliente que aloja el navegador desempaca el mensaje recibido para hacerlo llegar a la capa de aplicación que soporta el navegador web.
Escrito por: Sujel Melina Murillo Polanía

Si tienes información adicional sobre este tema, tus comentarios o links de referencia son bienvenidos. 

¿Para que se Utiliza la interfaz Loopback en protocolos de ruteo dinámico como OSPF?

OSPF utiliza la mayor dirección IP configurada en las interfaces como el identificador (ID) del router. Si alguna vez la interfaz asociada a esta dirección IP se cae, hay una intermitencia o si la dirección es eliminada, el protocolo OSPF debe recalcular un nuevo ID del router y reenviar toda la información de enrutamiento de sus interfaces.

El interfaz loopback es un interfaz virtual creada por software que representa al propio dispositivo independiente de la dirección IP que se la haya asignado, no existe físicamente en el equipo, pero realiza todas las funciones de un interfaz física. Se pueden crear tantos interfaces loopback como sean requeridas. 


Si la interfaz loopback está configurada con una dirección IP, el sistema operativo del router utilizará esta dirección IP como su ID de router, incluso si otras interfaces tienen direcciones IP mayores.  Así se logra una mayor estabilidad en la tabla de enrutamiento, debido a que las interfaces loopback nunca se caen y por lo tanto los protocolos de enrutamiento se mantienen latentes.

OSPF automáticamente prefiere una interfaz loopback sobre cualquier otro tipo de interfaz física, eligiendo así la mayor dirección IP entre todas las interfaces loopback. Si no hay presencia de interfaces loopback configuradas, elige como segunda opción a la mayor dirección IP del router. OSPF utiliza el algoritmo de
Dijkstra para seleccionar sus caminos de enrutamiento, por lo tanto no puede ser configurado para usar una interfaz específica.

Agradecimientos: Alfonso David Diaz Torres por su oportuna explicación

Si tienes información adicional sobre este tema, tus comentarios o links de referencia son bienvenidos. 

Friday, October 14, 2011

Linux MailServer con Exim: Comandos y directorios importantes

El archivo de configuración de Exim se puede modificar, a través de la consola de comandos:
gedit /etc/exim/exim4.conf

Los servicios de cualquier servidor Linux pueden activarse o desactivarse manualmente por medio de secuencias de comandos (scripts) en el archivo
/etc/init.d/Nombre_del_Servicio

Iniciar Servidor de Email

  • /etc/init.d/exim4 start
  • /etc/init.d/courier-all start
  • Detener Servidor de Email

  • /etc/init.d/exim4 stop
  • /etc/init.d/courier-all stop
  • Reiniciar Servidor de Email

  • /etc/init.d/exim4 restart
  • /etc/init.d/courier-all restart

  • El registro de mensajes salientes en la cola de correos que no han sido entregados se encuentra en
    /var/spool/exim4/msglog

    La información detallada sobre el contenido de los correos salientes (*- H = información del sobre, *- D = información del cuerpo)
     / var/spool/exim4/input

    Registro principal del Daemon Exim
    /var/log/exim4/mainlog

    Ver los emails en la cola que Exim trata de entregar
    exim4-qf

    Ver los emails en la cola de salida
    exim4-BP

    Número de emails en la cola de salida
    exim4-bpc

    Si tienes información adicional sobre este tema, tus comentarios o links de referencia son bienvenidos. 

    Herramientas SNMP, MIBs y funciones de la estación de Monitoreo

    Standard MIBs
    Define las características propias de SNMP como MIBs, traps , la interoperatividad entre las diferentes versiones. Además declara la estructura e identificación de la información administrada para diferentes protocolos de red como TCP/IP, UDP, IPv6 , IPv4, MLPS, LLDP, Link Aggregation, OSPF, RIP, DNS,  VRRP, entre otros. Así mismo para diferentes interfaces como ADSL, Ethernet, E1, E2, E3,DS1, DS2, DS3/E3, T1 , ATM and  Frame Relay.

    MIBs Activas:
    • Accesibilidad de Ping
    • Servicio de Prueba de puertos 
    • Servicio de verificación de contenido (HTTP, Telnet-Login inicio de sesión, POP3, IMAP, DNS, ...) y de Información interna, por ejemplo, SNMP, WMI, DMI, ...  
    MIBs Pasivas

    • Recopilación de registros (por ejemplo, Syslog,RADIUS)
    •  SNMP Traps 
    MIBs Análisis de eventos
    • Traps especiales
    • Texto en los registros (logs)
    • dependencias
    MIBs de Reacción
    • Recopilación de registros
    • Descripción del Estado
    • Notificaciones de alerta por SMS, e-mail, solicitudes al helpdesk...
    • reacciones automáticas ...

    Dependencias
    Muchas pruebas dependen de las condiciones de error que se generen en un entorno de red. Por ejemplo, si una estación de administración no puede alcanzar su propia puerta de enlace predeterminada, entonces cualquier dispositivo externo a la red local que intente conectarse a esta, generaría mensajes de error, como solución es necesario analizar la combinación entre los mensajes de error y el dispositivo comprometido. Si la estación de administración no puede alcanzar ni siquiera sus propios recursos fuera de la red local, entonces es realmente necesario analizar pruebas de  operación de la puerta de enlace predeterminada.
     
    Enterprise-Specific MIBs
    MIBs hechas por iniciativa privada tales como:
    • Objetos AAA que proveen soporte para monitorear autenticación, autorización y contabilidad (Accounting = todos los eventos puedan ser rastreados) a través de RADIUS, LDAP, SecurID, Firewalls y servidores de autenticación local.
    • Monitereo de Firewall, alarmas, analizadores, Políticas de seguridad
    • Chassis MIB Provee soporte para el monitoreo del entorno operativo de la carcasa (rack o chasis) donde se ubican los dispositivos de red (Fuente de poder, Voltajes del board, ventildaores, temperatura, flujo de aire, ...)
    • Monitoreo y estadísticas por interfaz
    • Bitácoras con el historial de cambios en los traps, la configuración de administración notifica el momento en el que se generó el cambio de configuración en cada trap, la identificación del usuario, el dispositivo de donde se generó la orden y el método utilizado.
    • Soporte para monitorear proxys DNS, solicitudes, peticiones, respuestas y fallas.
    • Ethernet MAC monitorea las estadísticas del media access control (MAC).
    • Flow Collection Services: Provee estadísticas de utilización de archivos, almacenamiento, memoria, FTP, estados de errores y monitoreo de interfaces, tambien provee traps  para destinos no disponibles, o transferencia de archivos no exitosa, desbordamiento de flujo o de memoria.
    • Multiple Instance Multiple Spanning Tree protocol MIMSTP
    • RMON Events and Alarms
    • Soporte Nat SUport 
    Software útil para usar en procedimientos de administración de redes, monitoreo y SNMP 

    ..Y muchos, muchos mas..., también es posible buscar por MIBs por ejemplo en


    Si tienes información adicional sobre este tema, tus comentarios o links de referencia son bienvenidos.