Tuesday, March 13, 2012

Enrutamiento: Transportando datos de aquí para allá

Enrutar es la acción de encaminar datos entre dos hosts, partiendo desde el host inicial hasta alcanzar un host de destino e independientemente de la configuración física o de la topología red. Un mejor nombre para esta capa podría ser “Capa IP” porque aquí es donde se usan las direcciones IP y se produce realmente el enrutamiento.

Recordemos que TCP/IP es un protocolo que trabaja en cuatro capas: aplicación, transporte, red y enlace. Cuando hablamos de enrutamiento debemos referirnos exclusivamente a la capa de red, debido a que el protocolo IP no tiene relevancia en la conexión física que se establece en la capa de enlace.

Cuando hablamos de Direcciones físicas y lógicas aprendimos como dirigir el tráfico a un host que reside en una red local, por medio de ARP (Address Resolution Protocol). Los hosts locales comparten el mismo identificador de red y la máscara de subred.

ARP se utiliza para difundir una petición a todos los hosts de la red local preguntando por un host específico, el cual responde con una dirección MAC que coincide con de dirección IP del destino deseado. Entonces, ¿cómo dirigir el tráfico a otras redes ya que ARP se emite únicamente en la red local? Ahí es donde entra en juego de enrutamiento.

Cada host posee una tabla de enrutamiento con un router por defecto como punto de intercambio de datos con otras redes. Si queremos enviar datos hacia un host especifico, el host de envío busca primero al host de destino en la red local. cuando este no lo encuentra localmente, se transmite el tráfico de datos al router por defecto alojado en la tabla de enrutamiento del host de envío.

El router se encarga de dirigir el tráfico a un tramo más cercano a su destino. Este salto puede ser a otro router al host de destino. En el caso de que el host de destino resida en una red conectada directamente a la interfaz del router.

¿Cómo los routers pueden direccionar correctamente el tráfico y cómo reciben información actualizada? Después de todo, Los routers mantienen tablas de enrutamiento con los caminos que ya que conocen, ellos usan protocolos dinámicos de ruteo para actualizar dichas tablas. Por lo tanto esto tiene que ser un proceso dinámico debido a que los caminos no son siempre los mismos y los routers cambian ya sea por fallos, actualización o expansión de las topologías de red.

Los protocolos de enrutamiento están divididos en dos grandes categorías:
  • Protocolos de puerta de enlace interior (IGP -Interior Gateway Protocol)
  • Protocolos de puerta de enlace exterior (EGPs -External Gateway Protocol)
Protocolos de puerta de enlace interior
Los protocolos IGP soportan tráfico de enrutamiento dentro de la red que está bajo su control administrativo, también conocido como Sistema Autónomo (AS). Este es un nombre elegante para todos los routers de una red local. El protocolo de información de ruteo (RIP -Routing Information Protocol) es un IGP ampliamente desplegado. RIP es un protocolo sencillo, que requiere de muy poca configuración y soporta esencialmente cada dispositivo. Otro IGP es Open Shortest Path First (OSPF). Estos dos protocolos difieren en la forma en que reciben actualizaciones de enrutamiento y su perspectiva en la búsqueda de las mejores rutas.

Protocolos de puerta de enlace exterior
Los Protocolos EGP son necesarios cuando los paquetes deben viajar entre diferentes Sistemas Autónomos. Estos protocolos sirven de puente entre Sistemas Autónomos separados dentro de una sola red, en la que todos los equipos de la red pueden interaccionar sin problemas con los demás. El Border Gateway Protocol (BGP) es ampliamente utilizado y parte del EGP. Actualmente, BGP proporciona el protocolo de enrutamiento que soporta el Backbone de Internet. Los servidores BGP de el Backbone de Internet deben mantener las tablas de enrutamiento que incluyan todas las direcciones externas de Internet.

Si tienes información adicional sobre este tema, tus comentarios o links de referencia serán bienvenidos.

Monday, March 05, 2012

Impacto de la formación de loops en la capa de enlace de datos


Los loops se generan cuando se usan dispositivos de interconexión como bridges y routers con el fin de generar varias rutas alternativas hacia un único dispositivo o segmento de red.  

Los siguientes son algunos de los fenómenos y consecuencias más comunes cuando hay loops en la capa de enlace de datos:

Tormentas broadcast

Los dispositivos de interconexión emiten tramas  broadcast y multicast por tiempo indefinido, cuando muchas tramas se encuentran atrapadas en un loop, se presenta un aumento considerable de tráfico y una disminución del rendimiento de la red. 

Ethernet blossoms with bus, star, mesh technology. By Kevin Burak and Roland Gendreau

 
La ausencia de campos TTL (Time To Live) en la capa 2, en contraste con la capa 3,  genera un consumo adicional del ancho del banda utilizado, por lo tanto, el tráfico legítimo no dispone de suficiente ancho de banda, en muchos casos la red se satura tanto que no está en condiciones de transmitir de datos.   

La solución es dividir la red con un router para evitar este tipo de reenvío indefinido o permitir la existencia de enlaces físicos redundantes pero creando una topología lógica libre de loops con STP, ya que este protocolo permite una sola trayectoria activa entre dos dispositivos de red, esto evita los bucles pero manteniendo las rutas redundantes como reserva, para activarlos en caso de que el camino principal falle.

Inestabilidad en la tabla de direcciones MAC: 

El switch registra las direcciones MAC aprendidas y mapea también sus puertos relacionados en una tabla dinámica. Si no hay tramas provenientes de dichas direcciones en un lapso de 300 segundos, la tabla elimina la dirección MAC. En el caso de presentarse un loop, la trama puede alcanzar una dirección MAC por diferentes puertos, y el switch no puede definir a dónde enviar la trama recibida.

Retransmisión de múltiples tramas

Una misma trama puede ser transmitida desde diferentes puertos, el receptor obtiene entonces múltiples copias de la misma trama repetida, esto también genera la saturación de trafico. Las tramas broadcast no son las únicas afectados por los loops, las tramas unicast enviadas a una red con loops pueden generar tramas duplicadas que llegan al dispositivo de destino.


Si tienes información adicional sobre este tema, tus comentarios o links de referencia serán bienvenidos.

Sunday, March 04, 2012

Ejemplos resueltos sobre analisis iterativo de la complejidad de algoritmos recursivos

"Para entender la recurrencia, primero hay que entender la recurrencia"

La recurrencia se presenta cuando un proceso se define basándose en función de si misma. Esto significa que una operación compleja se puede descomponer recursivamente en términos más sencillos, entonces los resultados parciales generados por las partes mas pequeñas se usan para encontrar la solución del problema completo.

El análisis de algoritmos es fundamental para entenderlos y aplicarlos en soluciones prácticas a problemas reales. Los aspectos que mas se estudian son el tiempo que tardan en ejecutarse, el rendimiento según los recursos de computación y el comportamiento en un nuevo entorno.
 
Las funciones recurrentes presentan grandes inconvenientes debido a que su  tiempo de ejecución tiende fácilmente a valores muy grandes o a infinito, ésto puede generar problemas de desbordamiento de memoria, por lo tanto, es necesario limitar su comportamiento con valores asintótico dados por la notación de Landou o más conocida como notación O grande.


La complejidad con que se ejecuta un algoritmo depende del número de datos de entrada el cual debe ser un valor finito. La relación de recurrencia está dada de la forma:
donde a ≥ 1y b >1 ademas
  • n es numero de datos que se analizan en todo el problema.
  • a es el número de partes en que se ha dividido el problema para estudiarlo recursivamente.
  • (n/b) tamaño de cada parte en que se ha dividido el problema, asumiendo el mismo tamaño para cada una.
  • f(n) es el costo de realizar las llamadas recursivas, incluyendo el proceso de dividir y volver a unir las subtotales para obtener la solución total.
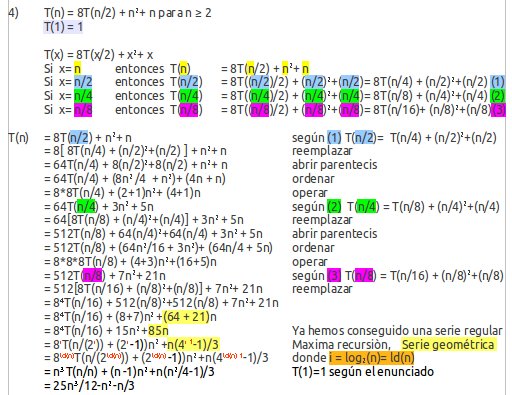
Los siguientes son 4 ejemplos de como analizar paso a paso  la complejidad del tiempo de ejecución en algoritmos recursivos:


Siguiente: Ejercicios resueltos usando  Teorema Maestro

Si tienes información adicional sobre este tema, tus comentarios o enlaces de referencia serán bienvenidos.

Tuesday, February 28, 2012

Diario de un ciberdelincuente

Muchos piratas informáticos están en el negocio para hacer transferencias bancarias ilegales, robar secretos comerciales, substraer información de Investigación y desarrollo, o obtener ventajas desleales sobre un rival, por ejemplo aplicar un ataque DoS a eBay en los últimos minutos de una subasta.


¿Que es lo que quieren los piratas informáticos? Esta es una pregunta demasiado general, porque su solución especificaría diferentes perfiles delictivos. Lo único claro es que aquel típico cliché del intruso entre 14 y 34 años de edad, adicto a la informática, sin ningún interés comercial, es una especie en vía de extinción.
Imagen de Bigstock
Hoy en día el panorama ha cambiado, algunos quieren Robar información mientras otros solo desean generar caos, sentar un precedente en señal de protesta,  o simplemente incrementar su ego al aparecer en los periódico y alardear en frente a un círculo de amigos.

Los intrusos que roban información confidencial van detrás de un bien específico. El botín puede variar desde códigos de activación de los juegos mas populares del momento, información bancaria, hasta secretos comerciales o gubernamentales. Los sistemas de gobierno poseen grandes cantidades de información personal sensible y muy valiosa, por lo que se encuentran en la categoría de alto riesgo.

En cuestiones de comerciales es muy común acosar empresas, políticos o figuras públicas modificando la información desplegada en sus páginas web oficiales, inhabilitar sistemas generando ataques de Denegación de servicio (DoS) que saturen los servidores de la competencia o simplemente robando información para obtener un beneficio personal.

Este es el caso de un estudiante anónimo de 21 años quien se hace llamar "0x80", el  requiere aproximadamente solo 2 minutos de trabajo diario para gestionar botnets y obtener Ingresos mensuales de $ 6.800 en promedio. ¿Como? Conversando con personas en los chats mientras que los bots le generan dinero [Krebs2006 ]. 

Si este suena como el trabajo de tus sueños sería bueno que revisaras cuales serían tus funciones:
  • Controlar mas de 13.000 computadores en más de 20 países.
  • Cuando los hosts infectados descargan parches, es necesario buscar nuevas víctimas
  • Desplegar publicidad de Adware y generar minería de datos de los hábitos de navegación de la víctima.
  • Mientras tanto los bots recogen contraseñas, direcciones de correo electrónico, numero de seguro social, datos bancarios y de tarjetas de crédito
  • Empresas como TopConverting.com, GammaCash.com, Loudcash o 180Solutions pagan por esta información.
http://www.microsoft.com
Interesante ¿verdad?, pero si te empeñas en empezar este estilo de vida, piénsalo muy bien, ya que algunos casos mas conocidos no han tenido finales felices. Por ejemplo Sean Smith pagó 5 años de prisión y una multa de 150.000 dolares por crear el virus Melisa (Mail-lissa), el cual fue desarrollado usando "Word" el procesador de texto de Microsoft office, este enviaba correo electrónicos masivos desde la propia cuenta del usuario a través de Outlook. Si un documento de Word que contenía el virus, ya fuera List.doc u otro archivo infectado, era descargado y abierto, se activaba la macro que lo replicaba.

Ehud Tenenbaum conocido como "The Analyzer" Irrumpió en la red del Departamento de Defensa EE.UU. Por lo que fue condenado a 6 meses de prisión y una multa de 18.000 dolares, mientras que Dmitry Sklyarov abrió el código de eBooks de Adobe y fue arrestado después de dar una conferencia titulada "Seguridad eBook - Teoría y práctica "en la convención de DEF CON en Las Vegas, Nevada. Él fue acusado de distribuir un producto diseñado para eludir las medidas de protección del copyright y arrestado por el FBI cuando se disponía a regresar a Moscú.

La confidencialidad es uno de los principales objetivos de la seguridad y se refiere a la exposición no autorizada de datos, es cuando terceros tienen acceso,  conocimiento o liberan intencionalmente información sensible de manera ilegal.

Existen dos formas de romper la confidencialidad del sistema, la primera es por intrusión no autorizada sobrepasando las protecciones de control de acceso y las políticas de seguridad del sistema. La segunda forma es la  Interceptación de paquetes y datos en transito, como correos electrónicos o interfiriendo canales de comunicación para obtener información a través de la observación de los patrones del tráfico de red con herramientas de análisis de tráfico como wireshark.

Imagen de http://blogofsysadmins.com
 En este enlace podrás descargar este interesante  Manual de análisis de tráfico con wireshark

En general los intrusos son externos, sin embargo las empresas también tienen que afrontar amenazas internas que son mucho mas difíciles de manejar debido a la relación de confianza que se genera entre las personas que trabajan en un proyecto de investigación y desarrollo. Sumado a que el nivel de habilidad necesaria para ocultar código malicioso es mucho menor que el requerido para encontrarlo, esto significa que es fácil ocultar código en grandes paquetes de software o instalar backdoors prácticamente imposibles de detectar, cualquier persona con acceso al medio desarrollo es capaz de ingresarlo.

Un ejemplo que cabe mencionar de amenazas internas es la de Rob Harris quien trabajaba en una fábrica de máquinas traga-monedas, el inyecto un código en la unidad de pruebas, para generar un algoritmo que activaba el modo ganador después de ingresar una secuencia específica de monedas, este código nunca fue detectado en el proceso de producción. Fue atrapado cuando su codicia despertó sospechas después de haber ganado mas de 100.000 dolares.

Los ejemplos expuestos anteriormente demuestran que la seguridad informática tiene aplicaciones en todos los ámbitos que rodean nuestros  entornos, desde el hogar, las compañías privadas y entidades gubernamentales, los riesgos de perder confidencialidad siempre están presentes y somos nosotros los profesionales de seguridad IT quienes debemos crear conciencia de como proteger nuestros sistemas.

Referencia: Krebs2006 : Krebs, B., Invasion of the Computer Snatchers, 2006

Mas información en: Seguridad IT III: La biodiversidad en el ecosistema de las vulnerabilidades

Si tienes información adicional sobre este tema, tus comentarios o links de referencia serán bienvenidos.

Monday, February 27, 2012

Seguridad IT III: La biodiversidad en el ecosistema de las vulnerabilidades

En la actualidad se ha vuelto recurrente escuchar de empresas cuyos sistemas han sido blanco de incidentes de seguridad. Cada día se lanzan millones de ataques criminales a equipos personales, corporativos y gubernamentales, este es uno de los grandes problemas que las mesas directivas tienen que resolver de manera prioritaria, armándose con un equipo de expertos en seguridad para proteger su información y creando una conciencia organizacional de la importancia de salvaguardar la información, mas ahora que esta tiene un precio,si no están lidiando con estos temas, lo hacen bajo su propio riesgo. Los recortes presupuéstales generan problemas para el personal de seguridad y un beneficio para los ciberdelincuentes.

 
Cada vez que nace un nuevo hito tecnológico surge una nueva amenaza, Cualquier aplicación Web debe estar desarrollada siguiendo estrictos controles de seguridad, las aplicaciones de redes sociales ya son blancos de ataques que aprovechan las relaciones de confianza entre amigos en línea para esparcir código malicioso, la visualización y Cloud Computing tan de moda en estos días se han hecho objetivos prioritarios de ataques de día cero, teniendo en cuenta que aún son tecnologías en desarrollo con posibles agujeros por descubrir.


Un ataque de día cero es una amenaza informática que trata de explotar las vulnerabilidades de software que son desconocidas por los propios desarrolladores del producto tecnológico. Aplicaciones como Google, Excel, Word, Powerpoint y muchas mas, han sido víctimas de estos agujeros de seguridad. El término deriva del momento en que se dio el insidente, el "día cero" en que ocurre el ataque y se toma conciencia de su existencia, el desarrollador no ha tenido la oportunidad de distribuir una solución de seguridad para los usuarios del software.

Otro peligro inminente son los dispositivos que han sido perdidos o robados como portátiles, memorias USB, teléfonos móviles y demás medios de almacenamiento, los cuales almacenan contienen información sensible y secretos industriales des propietarios, sumando también los computadores de segunda mano en especial los discos duros son fuentes inagotables de información que presentan un riesgo de fuga de información estando ahora en manos criminales son acceso limitado a estos datos.
Para aprender como proteger y prevenir un sistema de información de vulnerabilidades, ataques y malware, es necesario conocer los diferentes tipos de exploits. Se recomienda limitar su uso en sistemas diseñados exclusivamente para hacer pruebas controladas (sandboxes), ya que podrían causar causar graves daños en sistemas reales, así que es importante utilizar este conocimiento de forma responsable, con propósitos informativos y nunca en contra de algún usuario u organización [Stallin2008].


Malware, worms (gusanos) y troyanos se difunden a través de mensajería instantánea y correos electrónicos con imágenes, videos, y diapositivas, que solicitan su reenvío or medio de cadenas a mas contactos como requisito indispensable para que se cumpla algún buen propósito.

Fraudes como La carta Nigeriana (o estafa 419) aun siguen teniendo éxito, esta es una estafa en la que se convence a la víctima de pagar por adelantado alguna suma de dinero con la esperanza de realizar una ganancia significativamente mayor. Sin embargo esta no es la única tendencia de distribución de estos ataques, los ampliamente utilizados Blogs son otra alternativa, hay mas de 184 millones de blogs en todo el mundo, aproximadamente el 73% de los internautas han leído un blog de los cuales 50% han dejado comentarios posteriores, algunos blogs tienen enlaces automatizados que facilitan las referencias cruzadas y son fácilmente explotados por spammers.

Referencia:
Stoneburner2001: Stoneburner, G., Underlying Technical Models for IT Security, 2001
Stallin2008: Stallin, W., Computer Security: principles and Practice, 2008

Si tienes información adicional sobre este tema, tus comentarios o links de referencia serán bienvenidos.

Sunday, February 26, 2012

Seguridad IT II: La Seguridad y su rostro de Imperfección


En el mundo IT no existen sistemas completamente impenetrables, el aislamiento total es una solución que pierde total validez, ya que denigra el propósito operativo de las comunicaciones. La existencia de una pequeña imperfección ya sea por omisión o procedimiento podría llevar a una violación, e inmediatamente resaltar las vulnerabilidades existentes en el sistema de seguridad.
Existen dos formas de manejar este tipo de riesgos ya sean basados en Amenazas, vulnerabilidades o exploits (métodos que utiliza una amenaza para tomar  partido de una vulnerabilidad). Estos son la mitigación y la clasificación de las amenazas verificándolas formalmente haciendo pruebas en la Arquitectura y Diseño del sistema.

Una amenaza es la violación potencial a la seguridad de un sistema de información ya sea por engaño o por irrupción, estos generan consecuencias negativas en el funcionamiento y en la perdida de los objetivos de seguridad,  por lo tanto es necesario conocerlos evitarlos lo máximo que sea posible. 

Los engaños pueden presentarse a manera de:
  • Mascaradas: Obtener acceso a haciéndose pasar por un usuario autorizado.
  • Falsificación: Alteración, sustitución o introducción de datos falsos en un archivo o base de datos.
  • Repudio:  Cuando un usuario se niega a enviar o recibir datos.
Mientras que algunos ejemplos de irrupción son:
  • Incapacitación: Ataques a la disponibilidad del sistema; como troyanos, virus o worms.
  • Corrupción: Ataque a la integridad del sistema, los recursos del sistema o servicios funcionan de manera no deseada.
  • Obstrucción: Interferir con las comunicaciones mediante la desactivación de enlaces o alteración de la información de control. 
La gran mayoría de los ataques mencionados anteriormente so detectables mediante sistemas de monitoreo, sin embargo existen ataques pasivos que son difíciles de detectar al no haber alteración de datos, por ejemplo la liberación del contenido de mensajes o el análisis de tráfico, estos se pueden mitigar gracias a aplicaciones criptográficas [Stoneburner2001].

¿Cómo reunir evidencias de que un sistema cumple los requisitos de seguridad?, ¿Fue el sistema construido utilizando los métodos adecuados?, ¿Como saber si un producto IT o Software es seguro?. Estas preguntas pueden ser resueltas metódicamente mediante normas de evaluación de seguridad, ya sean como:


Estas normas reúnen procedimiento de seguimiento, representación de correspondencias, investigaciones y métodos formales para evaluar el nivel de seguridad de una empresa, además especifican los niveles de madurez de los procesos, planteando criterios para evaluar el nivel de seguridad en una organización, la Gestión de la Configuración administra procesos de entrada, seguimiento de cambios, aseguramiento de procedimientos seguidos, pruebas de retorno al estado anterior y actualizaciones de sistemas sensibles. 


Reference: Stoneburner2001: Stoneburner, G., Underlying Technical Models for IT Security, 2001


Si tienes información adicional sobre este tema, tus comentarios o links de referencia serán bienvenidos.

Seguridad IT: Introducción a la seguridad de los sistemas de información


Si bien el campo de la seguridad informática es amplio e inagotable, este documento trata de abordar de manera general algunos conceptos fundamentales a la hora de describir los riesgos a los que se encuentran expuestos los sistemas informáticos. Cabe tener en cuenta que muchos de los ataques no usan computadores, estos se basan en métodos de Ingeniería social, un poco de investigación para recopilar información de la cadena de mando, además de una simple llamada al administrador del sistema haciéndose pasar como un ejecutivo que ha perdido su contraseña, por lo que requiere establecerla nuevamente, es una forma ingeniosa de obtener acceso a una cuenta con altos privilegios. casos como este son expuestos en el libro “Corporate Espionage” de Ira Winkler.


Existen varias hipótesis que hablan sobre la posibilidad de que una guerra cibernética pueda desencadenarse en un futuro cercano. Estas tesis no son descabelladas si tenemos en cuenta varios factores coyunturales como: La gran cantidad de amenazas que infestan la red, la fuerte inversión que se ha hecho al desarrollo de las tecnologías de la información (IT) y el alto grado que se ha alcanzado en cuanto a la automatización de todo tipo de procesos operativos.

Actualmente casi todo esta controlado por sistemas de computo desde la administración de redes eléctricas, instituciones financieras hasta el registro de los ciudadanos de muchos países. Un ataque cibernético bien planificado necesitaría   el simple clic de un mouse, para acabar con oficinas gubernamentales y corporaciones multinacionales, esto podría ser un desastre de proporciones indescriptible, si llegara a "colapsar" la estabilidad de un país.


Seguridad con un propósito
El propósito la seguridad en las de tecnología de la información es permitir que las organizaciones cumplan su misión y sus objetivos de negocio, esto se logra mediante la implementación de sistemas que vigilan y protegen los recursos informáticos de los posibles riesgos a los que encuentran expuestos.

Las políticas de seguridad definen lo que está o no permitido hacer en el sistema IT, ellas describen las reglas para asegurar un sistema de información,
Las políticas de seguridad deben definidas congruentemente ya que su discrepancia causa conflictos entre ellas desencadenando vulnerabilidades o puntos débiles.  

Los mecanismos de seguridad refuerzan las políticas de seguridad, corrigiendo sus limitaciones, el flujo de datos entre ellas y las restricciones de acceso a datos personales y/o otras aplicaciones. Por lo tanto, es importante asegurarse de que todas la política de seguridad sean impuestas por mecanismos suficientemente fuertes, siguiendo metodologías de organización y estrategias de evaluación de riesgos que aseguren el cumplimiento de los objetivos de seguridad. Los cuales están descritos en la siguiente tabla:


Continuación: Seguridad IT II


Si tienes información adicional sobre este tema, tus comentarios o links de referencia serán bienvenidos.

DNS I: Introducción al Sistema de Nombre de Dominio (Domain Name System)

DNS es un sistema de bases de datos distribuidas, cuyas tablas de direcciones no se almacenan totalmente en un único host, sino que están distribuidas a través de varios servidores.

¿Que es un Dominio?

Un dominio es una división lógica del DNS y por lo tanto de su base de datos.

Cada dominio representa una rebanada de todo el pastel DNS. Los siete primeros dominios "genéricos" mas conocidos tienen terminaciones de tres letras (.com, .org, .edu, .net, y otros menos extendidos como .int, .gov, y .mil). La lista de dominios principales se ha ampliado para incluir .aero, .biz, .coop, .info, .museum .name, .pro, etc. Cuando hablamos de dominios genéricos podemos pensar en los dominios que utilizamos todos los días (por ejemplo: google.com o yahoo.com). 

También hay dominios de dos letras, que a menudo representan códigos de países como por ejemplo Colombia (.co), México (.mx), España (.es), los Estados Unidos (us), Francia (.fr), el Reino Unido(.uk) y Austria (.at) entre muchos otros.

Anteriormente las direcciones IP y nombres de dominio se mantenían en tablas que eran descargas cada noche. A medida que Internet fue creciendo, esto se volvió poco práctico, especialmente por el tamaño de las tablas y las cuestiones relacionadas con algún punto de fallo. Este es un extracto de el archivo estático /etc/hosts de un servidor basado en UNIX: 

A pesar de que los equipos UNIX y Windows aun albergan un pequeño archivo llamado etc/host con las direcciones utilizadas frecuentemente, esta función ha sido aumentada agregando capacidades DNS. Los equipos  están configurados para  buscar primero de forma recursiva en el archivo etc/hosts, si el dispositivo solicitado no se encuentra allí, busca el DNS para la resolverlo Iterativamente.

¿cómo funciona realmente una resolución de nombres DNS? 
Las personas se refieren a los hosts por nombres fáciles de recordar y generados  por inspiración divina :), mientras que los computadores se refieren a los hosts por su dirección IP binaria. Después de todo, El datagrama IP posee un campo para la  dirección IP y no para  el nombre del host.  

A nivel muy básico podemos decir que una resolución DNS traduce una dirección IP a un nombre de host, o de manera inversa, un nombre de host en una dirección IP. Esto implica dos rutinas de resolución: gethostbyname (obtener el host por nombre) y gethostbyaddr (obtener el host por dirección).

 
Cuando un host emite una petición gethostbyaddr, este entrega una dirección IP al servidor DNS y le solicita que resuelva el nombre de host. Hay mucho más para procesar que lo que se ve a simple vista. Por el contrario, una petición gethostbyname entrega el nombre de un host al servidor DNS, solicitando la resolución una dirección IP.

NSLOOKUP: Herramienta de consulta DNS, es muy fácil de usar, solo digitas nslookup desde el prompt de windows o la terminal de de linux, y ya puedes jugar con sus diferentes opciones.


nslookup en línea: http://centralops.net/co/NsLookup.aspx 


Si tienes información adicional sobre este tema, tus comentarios o links de referencia serán bienvenidos.

Thursday, February 16, 2012

Algunos Protocolos TCP/UDP y Puertos de servicio

TCP y UDP poseen campos de 16 bits (2 bytes) en su respectivo encabezado para almacenar el número de puerto. Esto significa que pueden tener hasta 65.536 diferentes puertos o servicios, los cuales se numeran desde 0 a 65.535. 

Es importante tener en cuenta que a pesar de que un servicio está normalmente asignado a su número de puerto, nada garantiza que esto se cumpla. Telnet, por ejemplo, se encuentra normalmente en el puerto 23 de TCP. Nada lo detiene de ofrecerse en el puerto 31337.Cualquier servicio se puede ejecutar en cualquier puerto. Pero si desea trabajar en red con otros hosts, lo mejor es seguir las normas.  

Los puertos y servicios mas comunes se encuentran en el archivo /etc/services de los hosts basados en UNIX (Como Linux y MAC), este es un excelente recurso para hacer coincidir servicios TCP y UDP con los números de puertos mas comunes. (Ver la lista de los puertos de servicio en este Enlace) 

Si quieres ver esta lista de puertos disponibles en tu equipo solamente debes ejecutar tu consola terminal y digitar el siguiente comando:

cat /etc/services

El siguiente es un extracto con algunos de los servicios y sus puertos asociados mas comunes, Algunos de estos son ofrecidos en protocolos TCP y UDP simultaneamente. Esto es normal pero inusual, la mayoría de servicios se ofrecen en TCP o UDP.


La siguiente Figura muestra un paquete con un servicio especificado. En este caso, un encabezado UDP tiene un campo de 16 bits (2 bytes) conocido como "puerto de destino". Aquí se indica el servicio o puerto solicitado. En este ejemplo, el valor del campo de encabezado UDP representa el puerto número 53, lo que significa que el datagrama contiene datos para el Sistema de Nombre de Dominio (DNS -Domain Name System).

Anteriormente, los puertos con números menores a 1024 tenían un significado especial, y eran denominados puertos confiables (trusted ports) porque sólo el root podía usarlos. El término se originó porque dichos puertos eran asignados por los procesos internos del sistema. Por lo tanto, si un host externo mostraba una conexión entrante con un puerto de origen menor a 1024, se suponía que era confiable.

Esto tenia mucho sentido cuando Internet era un lugar seguro, pero hoy en día, esto no es tan cierto. Sin embargo ahora los puertos mayores a 1204 son los que tienen un significado especial y son a menudo llamados puertos efímeros, lo que significa que podría ser utilizados por la mayoría de servicios para cualquier propósito.

Cuando un hacker vulnera un sistema, este evita dejar huellas, la mejor manera de ocultarlas, es abriendo un servicio por un puerto efímero e inesperado, diferente al puerto convencional y preferiblemente de alta numeración. Esto hace que su conexión no autorizada sea más difícil de encontrar e identificar. 

Protocolos IP

Cuando un usuario utiliza una aplicación, como FTP para transferir archivos, telnet como un emulador de terminal, o el correo electrónico para transmitir chistes e historias a sus amigos más cercanos, este interactua las cuatro capas principales del modelo TCP/IP, la aplicación toma el mensaje, la información o el proceso del usuario, y lo organiza para ser enviado a través de las tres capas restantes que son transporte, red y enlace.
Aclaremos que existen dos modelos diferentes de transporte: un modelo orientado a la conexión (TCP) y otro no orientado a la conexión (UDP). Orientado a la conexión significa exactamente lo que parece: El software hace todo lo posible para garantizar que la comunicación es fiable y completa, el proceso que inicia el establecimiento de la conexión, se denomina Handshake (apretón de manos). Por el contrario, Cuando el modelo es No orientado a la conexión, se hace el envío y se reza para que llegue, debido a que no tiene ningún proceso de Hanshake o promesa de fiabilidad. Toda la confiabilidad ofrecida debe ser incorporada en la aplicación. La siguiente Tabla resume algunos de los atributos TCP y UDP.

UDP es un protocolo de comunicación fácil de comprender, después de todo, los paquetes se arman y se lanzan a la red. El host de destino recoge, desempaca (retira los encabezados de la capa respectiva y envía el resultado al protocolo de la capa superior correspondiente), y extrae el mensaje. Ciertamente, algunos datagramas podrían perderse en el camino, pero en general funciona ya que esto no es un problema para muchas aplicaciones. 
Al enviar audio, una  palabra se puede perder, probablemente la mente podría compensarla y rellenaría la palabra faltante. Si el caso fuera el envío de vídeo, tal vez habría un pequeño punto vacío donde los paquetes se perdieron. La mayoría de las veces, esto es aceptable. Los datos que viajan a través de UDP no son  necesariamente fiables; pero UDP en sí mismo no es responsable de esto. La aplicación debe ignorar las piezas que faltan o pedirlas de nuevo.

¿Qué pasa tenemos una aplicación que no puede tolerar la pérdida de paquetes? Utilizamos TCP para asegurar que todos los datos enviados se reciben. Existen varios mecanismos  para verificar la entrega y la secuencia adecuada de los datos TCP. Uno de los medios de control es la confirmación de recibido (ACK -Acknowledgement), el cual vuelve muy confiable al protocolo  TCP  porque cada paquete es confirmado después de que el host de destino lo recibe. 
Si un paquete no se recibe (y por lo tanto no es confirmado), se reenvía. De este modo, el TCP se asegura de que todos los paquetes son recibidos, por lo que se considera un servicio confiable. Esta es una forma mas lenta de negociar, pero se pueden establecer ciertas optimizaciones para acelerar el proceso. Dicho esto, el TCP siempre será más lento que UDP.

El último protocolo IP discutido aquí es el Internet Control Message Protocol (ICMP), que es un conjunto de aplicaciones fascinante y ligero, originalmente creado para solucionar problemas de red y para reportar condiciones de error. La solicitud ICMP más conocida sin duda es: echo request/ echo reply (ping). Podemos usar un ping para determinar si un host de red es accesible. Otras aplicaciones de ICMP se utilizan para el control de flujo, cambio de ruta de paquetes y recopilación  de información de red (por nombrar sólo algunas de las funciones).

Si tienes información adicional sobre este tema, tus comentarios o links de referencia serán bienvenidos.
Redes: Diferencia entre direcciones Físicas y Lógicas

Lo más probable es que haya oído el término dirección IP. Pero ¿Qué representa realmente? ¿ para que sirve? ¿que hace?  ¿Cómo direcciona exactamente los host? Estos son algunos de los temas tratados en esta sección.

Direcciones físicas: MAC (control de acceso a el medio)


Podriamos buscar hasta el cansancio las direcciones MAC de la capa física en los encabezados de los paquetes IP pero no las vamos a encontrar. Las direccione MAC no significan nada para el protocolo IP, el cual  utiliza direcciones lógicas que no son parte del protocolo. Para todos los efectos, estas direcciones pueden o no existir. Por la misma razón, las direcciones MAC físicas son como las interfaces de la tarjeta Ethernet en la red. Pero La tarjeta NIC de Ethernet no sabe sobre IP, cabeceras IP, ni direcciones IP lógicas. Por lo tanto, nos enfrentamos a una falta de comunicación. Es evidente que para hacer que el sistema funcione, se necesita un proceso operativo que facilite la conversión entre direcciones IP lógicas y direcciones MAC físicas.

¿Conoce la dirección IP de su computador? Si la respuesta es no, usted no se está quedando atrás, es absolutamente normal no saberla debido a varias razones, No muchos pueden tener su propia dirección IP o incluso siempre nos conectamos con una dirección IP diferente. Una dirección IP es un bien muy preciado. Cuando usted se conecta a la red, Un proveedor de servicios Internet (ISP -Internet Service Provider) o un proveedor de servicios de red (-Network Service Provider) le prestan una dirección IP solo por el período en que dura la sesión de conexión, o posiblemente por un tiempo mas largo, esto a través de aplicaciones, tales como el Protocolo de configuración dinámica de host (DHCP -Dynamic Host Configuration Protocol) .

¿Exactamente cuántas posibles direcciones IP existen? El número exacto es de 2^32 (porque la dirección se compone de 32 bits), este es un número superior a 4 billones. Sin embargo, no todas las  direcciones IP están disponibles; los rangos reservados disminuyen la cantidad de números posibles.

Con el explosivo crecimiento de Internet a nivel mundial, la preocupante realidad indica que las direcciones IP se están agotando rápidamente. ¿Cuáles son algunas soluciones para afrontar el agotamiento de direcciones? En primer lugar, una red local particular puede usar DHCP y asignar direcciones IP temporalmente a sus usuarios mientras dura la conexión. Esto significa que no todos los hosts estarán activos en un momento dado, así se requiere un grupo menor de posibles direcciones IP.

La otro solución es conocida como  direcciones privadas reservadas (Reserved private addresses). La entidad gubernamental que las regula es Internet Address Numbers Authority (IANA), ha estandarizado los bloques de direcciones IP que se utilizan para la asignación de direcciones internas. Por lo tanto, las subredes 192.168 y 172.16 se utilizan para los hosts de redes privadas. Este tráfico no debe traspasar la puerta de enlace (gateway) de la red local. Esto permite que una red local con un limitado número de direcciones IP, pueda usar direcciones Clase B  para propósitos internos y para guardar la direcciones IP externas previamente asignadas con otros fines.

Algunos conocen su dirección IP pero ¿Conoce de memoria la dirección MAC de su host? La respuesta más probable es "No", porque casi nadie se sabe su dirección MAC. Hay varias razones para esto, pero la principal es que esta es una dirección de 48 bits, sin facilidades para ser humanamente memorizable, por lo tanto es  difícil asimilar para el cerebro.

El Protocolo de resolución de direcciones (ARP -Address Resolution Protocol) permite resolver la traducción de direcciones MAC física a direcciones IP lógicas. ARP no es un protocolo IP, es el proceso de envío de una trama de Ethernet a todos los sistemas en el mismo segmento de red. Esto se conoce como difusión (broadcast).


Cuando un mensaje se emite, se envía a todas las máquinas de un segmento de red o a una red completa. Es importante destacar que ARP se aplica únicamente para hosts localmente conectados a  la misma red, no funciona entre hosts de diferentes redes.

El host de origen emite (o difunde) las solicitudes ARP,  luego el host de destino las recibe y responde con su dirección MAC. Durante esta operación, todos los hosts que escuchan en la red, incluyendo los hosts de origen y destino, guardan en caché lo que han aprendido sobre los otros hosts, por lo tanto almacenan sus direcciones IP y MAC. Este almacenamiento reduce el número de nuevas peticiones ARP requeridas.

Finalmente la comunicación dentro de un mismo segmento de red se produce entre las direcciones MAC  y no entre las direcciones IP. Dos hosts se pueden comenzar a comunicar con transacciones TCP/IP de la misma capa, pero la comunicación efectiva se produce entre las direcciones MAC de los dos hosts.

¿Por qué son las direcciones MAC de tan grandes? Después de todo, Una dirección de 48 bits es enorme. ¡La idea es que sean totalmente únicas temporal y espacialmente! :). Esto suena bien si se dice  rápido, pero los planes futuros requieren expandir este valor a 128 bits para adaptarse a sus limitaciones actuales, permitiendo que cada fabricante de NICs pueda tener un código de proveedor único integrado en la dirección MAC.

Direcciones Lógicas: direcciones IP

Una dirección IP tiene 32 bits asignados para identificar un host. Este número de 32 bits se expresa como cuatro números decimales separados por puntos (por ejemplo, 192.168.5.5). Estas no son  asignaciones secuenciales o al azar. La parte inicial del número de IP indica el tamaño de la red en la que reside el host. El resto de la dirección IP identifica a el hosts de la red.

Las direcciones se clasifican por clases,  las clases indican cuántos equipos se encuentran en una determinada red o la cantidad de bits asignados en la dirección IP para los hosts únicos en la red, como en la siguiente tabla. Las direcciones de clase A asignan los primeros 8 bits a un segmento de la red a la dirección IP,  y los restantes 24 bits para la identificación del host. Debido a que 24 bits han sido asignados para el host mas de 16 millones (224-1) hosts, podrían ser asignados. Un ejemplo de red Clase A va desde 18.0.0.0 a 18.255.255.255, el rango IP asignado al Instituto Tecnológico de Massachusetts (MIT).


Las direcciones IP se clasifican desde la clase A a la Clase E. Las direcciones de clases A, B y C envían paquetes a un único host de destino (unicast). Mientras que las direcciones de Clase D se conocen como multicast y son utilizadas para la comunicación entre un grupo designado de hosts. Las direcciones Clase E están reservadas para uso experimental. La siguiente Tabla muestra el rango de direcciones asociadas a cada clase.


Máscara de Subred

Esta máscara informa a un sistema de computación que parte de su dirección IP ha sido asignada a la red y que parte al host. Cada bit que representa a la red se marca como 1.  Por ejemplo, Una dirección clase A, tiene 8 bits de red y 24 bits de host. En binario, 8 bits consecutivos (todas con valor de 1) se traducen en un número decimal 255. Entonces, la máscara de subred es designada como 255.0.0.0. Otras clases tienen otras máscaras de subred. Una red clase B tiene una máscara de subred 255.255.0.0, y una red clase C tiene una máscara de subred 255.255.255.0.

¿Por qué es necesario saber qué clase y cuántos bits se reservan para la red mediante el análisis de dirección IP? porque algunos administradores de red subdividen sus redes. Por ejemplo, una red de clase C se puede dividir en cuatro subredes individuales mediante la asignación de una máscara de subred adecuada.

Notación CIDR

Direccionamiento se refiere al enrutamiento entre dominios sin Clases (CIDR Classless Inter-domain routing). Durante mucho tiempo, las direcciones fueron parte de una clase particular. Esto significaba que su red sería asignada con 16 millones+, 65 000+, o 255 hosts. La situación más frecuente eran las redes que requerían entre 255 y 65.000 hosts. Debido a que muchas de estas redes eran de clase B, muchos números IP quedaban sin ser asignados. Teniendo en cuenta que los números de IP son bienes finitos, una solución fue asignar redes sin restricciones de clase.

CIDR asigna redes, sin los límites de 8 bits, pero con límites de un solo bit. Esto permite que una red  reciba el número apropiado de direcciones IP,  con lo cual se reduce el desperdicio. CIDR usa una única  notación para designar el rango de los hosts asignado a una red. Si desea especificar el rango de direcciones 192.168 en CIDR, se verá como 192.168/16. La primera parte de la notación es la representación decimal del patrón de bits asignado a la red. Al cual le sigue una barra inclinada y luego el número que indica los bits que representan  el segmento de red en la dirección. Este ejemplo es el mismo que una red de clase B, pero se puede modificar fácilmente para representar redes más pequeñas.