Monday, March 26, 2012

Heap

Heap se traduce como montículo, pero antes de hablar de estructuras de datos quiero definir que es un montículo, la verdad cuando yo leí la definición por primera vez no fui capaz de entender el concepto, así que lo quiero aclarar por si tu tuviste mi mismo problema:

Un montículo es una agrupación de cosas una sobre otras, en Colombia decimos de forma muy castiza “montonsito” o un bonche” de cosas. Asi que podemos hablar de montículos de frutas, monedas, arena, nueces, o cualquier cosa que se te ocurra.

Ahora si entrando en materia un Montículo es una estructura de datos en forma de árbol binario completo, el cual posee un algoritmo que organiza los nodos según su valor, ya sea en orden ascendente o descendente.

Recordemos que los árboles binarios poseen nodos que tienen máximo 2 nodos hijos, Un árbol binario es completo cuando los nodos de ambas ramas (izquierda y derecha) están balanceadas y ademas todos sus niveles están llenos excepto el último nivel, donde todos los nodos están hacia un mismo lado.

Maxheap: La cima contiene el elemento mayor y todos los hijos son menores que su padre (hijo<= padre), se observa como los números disminuyen a medida que descendemos en el montículo 


MinHeap: La cima contiene el elemento menor, todos los padres son menores que sus hijos (padre <=hijo) se observa como los números aumentan a medida que descendemos en el montículo


Si tienes información adicional sobre este tema, tus comentarios, dudas o enlaces de referencia serán bienvenidos.

Friday, March 23, 2012

6 ejemplos de Arboles AVL

Los arboles AVL son árboles binario con una propiedad adicional: se balancean automáticamente teniendo en cuenta el factor de balance (FB) y el valor de cada nodo que insertamos o eliminamos. En el  enlace Estructura de Datos: Arboles puedes conocer mas sobre la  terminología que usamos en este artículo.

El factor de balance (FB) de un nodo es la diferencia de alturas entre la rama izquierda menos la derecha, para que el árbol esté balanceado este valor solo pueden ser -1, 0 ó 1.

FB= altura(arbol.izq)-altura(arbol.der)

Para lograr el balance adecuado, debemos ubicar al nodo hijo en la posición correcta antes de hacer cualquier rotación. 

Cuando la rotación se hace con nodos externos hablamos de rotación sencilla, mientras que si se trata de nodos internos o que requieran un cambio de dirección del nodo, se refiere a una rotación doble.

Ejemplos de Auto-balanceo


1.  En este ejemplo iniciamos con un árbol balanceado, pero en el paso 2 vamos a insertar el nodo 16 en el nodo hoja número 17, esta inserción des-balancea el árbol especialmente al nodo 13, por lo tanto con este nodo es que haremos una  rotación  doble izquierda-derecha.

 
2. Ahora queremos insertar 2 en el nodo hoja 3,  esto des-balancea el árbol en el nodo interno 4, por lo tanto hacemos una rotación sencilla a la derecha y  finalmente logramos balancear el árbol 

 
3.Insertamos 3 en el nodo hoja 2, el nodo de des-balance es 4, así que hacemos una rotación doble derecha-izquierda

4. Insertamos 7 en el nodo hoja 8, el nodo de des-balance es 6, así que hacemos una rotación doble derecha (7-8)-izquierda.

5. Insertamos 9 en el nodo hoja 8, el des.balance se genera en el nodo interno 5, desplazamos el nodo 7 hacia arriba, esta es una rotación simple a la izquierda (solo interactuan los nodos 4, 5 y 7 en la rotación) , el nodo hoja 6 ahora depende de 5.


6. Este era el punto del examen :) así que tiene truco,  Esta es una rotación doble izquierda-derecha usando  los nodos 6 en la raiz, 9 y 7. 


Si tienes información adicional sobre este tema, tus comentarios, dudas  o enlaces de referencia serán bienvenidos, .

Wednesday, March 21, 2012

Formas de recorrer un arbol

Recorrido:Es la forma de visitar todos los nodos de un árbol siguiendo un orden específico
Pre-orden: Procesa primero el nodo y después cada hijo es procesado recursivamente de izquierda a derecha


Pos-orden: Procesa primero cada nodo hijo recursivamente y después procesa al nodo


Siguiente: Árboles Binarios

Si tienes información adicional sobre este tema, tus comentarios o links de referencia serán bienvenidos.

Tuesday, March 20, 2012

Estructura de Datos: Arboles


Un árbol es una estructura de datos no lineal y jerárquicamente organizada, cuyos elementos son nodos conectados por bordes que no forman ciclos. Todo árbol tiene un nodo raíz de donde descienden mas nodos, existe solo un camino para acceder a cada nodo desde la raíz.
Algunos ejemplos de arboles son: la tabla de contenido de un libro o el sistema de archivos de cualquier sistema operativo ya sea Unix, DOS o Windows.
 
Datos importantes y terminología
  • Un árbol con n nodos tiene n-1 bordes o conectores
  • La raíz es un nodo sin padres o ancestros
  • las hojas son los nodos mas externos sin hijos o descendientes
  • hermanos son nodos con el mismo padre

Longitud de un camino
: el el número de bordes que se pueden seguir desde un nodo hasta alcanzar otro nodo

Profundidad
: Número de bordes desde la raíz a el nodo, la profundidad del nodo raíz siempre es 0

Altura: Longitud del camino mas largo desde la raíz al a la hoja mas profunda que se pueda alcanzar.

Tamaño del nodo: Es la suma de todos los nodos descendientes mas uno, que equivale al nodo que estamos midiendo, el tamaño de la raíz determina el tamaño del árbol.

Estructuras para implementar árboles

Con una lista enlazada

Con una matriz si sabemos el número máximo de hijos que poseen los nodos


Siguiente:Formas de recorrer un árbol


Si tienes información adicional sobre este tema, tus comentarios o enlaces de referencia serán bienvenidos.

Thursday, March 15, 2012

13 Ejercicios Resueltos paso a paso sobre recursividad usando Teorema Maestro

-->
El teorema maestro proporciona una solución paso a paso para estudiar el comportamiento del tiempo de ejecución de algoritmos que cumplen las siguiente relación de recurrencia:

donde T(n) es el tiempo de ejecución, a ≥ 1 y b >1 son constantes ademas
  • n es el tamaño de todo el problema.
  • a es el número de partes en que se ha dividido el problema original para estudiarlo recursivamente.
  • (n/b) tamaño de cada parte en que se ha dividido el problema, asumiendo el mismo tamaño para cada parte.
  • f(n) es el costo de realizar las llamadas recursivas, incluye el trabajo de dividir el problema y volver a unir las subtotales para obtener la solución total. F(n)  es un función independiente de T(n) y no negativa.
La relación de recurrencia se analiza expandiendo iterativamente el tiempo de ejecución y sustituyéndose en la misma ecuación, para evitar esta expansión se puede determinar un límite asintótico usando la notación de Landau (O grande) usada comúnmente en el análisis algoritmos Divide y vencerás.
Es posible determinar tres tipos de casos asintóticos --> d = logb(a):


Ejemplos Resueltos
Caso 1
T(n)= Θ(nlogb(a)) Si existe alguna constante ε > 0 tal que f(n) ∈ O(nlogb(a) –ᵋ) 


Caso 2
-->
T(n)= Θ(n logb(a) logk+1(n)) Si f(n) ∈ Θ(n logb(a) logk(n) ) para cualquier constante k ≥ 0

Caso 3
-->
T(n)= Θ(f(n)) SI existe ε> 0 tal que f(n) ∈ Ω (nlog b(a) + ε) la segunda condición es que exista alguna constante c < 1 tal que para todo n≥ 1 se cumple que: af(n/b)≤ cf(n)

También te interesa: Ejemplos resueltos sobre analisis iterativo de la complejidad de algoritmos recursivos

Si tienes información adicional sobre este tema, tus comentarios o links de referencia serán bienvenidos.

Tuesday, March 13, 2012

Enrutamiento: Transportando datos de aquí para allá

Enrutar es la acción de encaminar datos entre dos hosts, partiendo desde el host inicial hasta alcanzar un host de destino e independientemente de la configuración física o de la topología red. Un mejor nombre para esta capa podría ser “Capa IP” porque aquí es donde se usan las direcciones IP y se produce realmente el enrutamiento.

Recordemos que TCP/IP es un protocolo que trabaja en cuatro capas: aplicación, transporte, red y enlace. Cuando hablamos de enrutamiento debemos referirnos exclusivamente a la capa de red, debido a que el protocolo IP no tiene relevancia en la conexión física que se establece en la capa de enlace.

Cuando hablamos de Direcciones físicas y lógicas aprendimos como dirigir el tráfico a un host que reside en una red local, por medio de ARP (Address Resolution Protocol). Los hosts locales comparten el mismo identificador de red y la máscara de subred.

ARP se utiliza para difundir una petición a todos los hosts de la red local preguntando por un host específico, el cual responde con una dirección MAC que coincide con de dirección IP del destino deseado. Entonces, ¿cómo dirigir el tráfico a otras redes ya que ARP se emite únicamente en la red local? Ahí es donde entra en juego de enrutamiento.

Cada host posee una tabla de enrutamiento con un router por defecto como punto de intercambio de datos con otras redes. Si queremos enviar datos hacia un host especifico, el host de envío busca primero al host de destino en la red local. cuando este no lo encuentra localmente, se transmite el tráfico de datos al router por defecto alojado en la tabla de enrutamiento del host de envío.

El router se encarga de dirigir el tráfico a un tramo más cercano a su destino. Este salto puede ser a otro router al host de destino. En el caso de que el host de destino resida en una red conectada directamente a la interfaz del router.

¿Cómo los routers pueden direccionar correctamente el tráfico y cómo reciben información actualizada? Después de todo, Los routers mantienen tablas de enrutamiento con los caminos que ya que conocen, ellos usan protocolos dinámicos de ruteo para actualizar dichas tablas. Por lo tanto esto tiene que ser un proceso dinámico debido a que los caminos no son siempre los mismos y los routers cambian ya sea por fallos, actualización o expansión de las topologías de red.

Los protocolos de enrutamiento están divididos en dos grandes categorías:
  • Protocolos de puerta de enlace interior (IGP -Interior Gateway Protocol)
  • Protocolos de puerta de enlace exterior (EGPs -External Gateway Protocol)
Protocolos de puerta de enlace interior
Los protocolos IGP soportan tráfico de enrutamiento dentro de la red que está bajo su control administrativo, también conocido como Sistema Autónomo (AS). Este es un nombre elegante para todos los routers de una red local. El protocolo de información de ruteo (RIP -Routing Information Protocol) es un IGP ampliamente desplegado. RIP es un protocolo sencillo, que requiere de muy poca configuración y soporta esencialmente cada dispositivo. Otro IGP es Open Shortest Path First (OSPF). Estos dos protocolos difieren en la forma en que reciben actualizaciones de enrutamiento y su perspectiva en la búsqueda de las mejores rutas.

Protocolos de puerta de enlace exterior
Los Protocolos EGP son necesarios cuando los paquetes deben viajar entre diferentes Sistemas Autónomos. Estos protocolos sirven de puente entre Sistemas Autónomos separados dentro de una sola red, en la que todos los equipos de la red pueden interaccionar sin problemas con los demás. El Border Gateway Protocol (BGP) es ampliamente utilizado y parte del EGP. Actualmente, BGP proporciona el protocolo de enrutamiento que soporta el Backbone de Internet. Los servidores BGP de el Backbone de Internet deben mantener las tablas de enrutamiento que incluyan todas las direcciones externas de Internet.

Si tienes información adicional sobre este tema, tus comentarios o links de referencia serán bienvenidos.

Monday, March 05, 2012

Impacto de la formación de loops en la capa de enlace de datos


Los loops se generan cuando se usan dispositivos de interconexión como bridges y routers con el fin de generar varias rutas alternativas hacia un único dispositivo o segmento de red.  

Los siguientes son algunos de los fenómenos y consecuencias más comunes cuando hay loops en la capa de enlace de datos:

Tormentas broadcast

Los dispositivos de interconexión emiten tramas  broadcast y multicast por tiempo indefinido, cuando muchas tramas se encuentran atrapadas en un loop, se presenta un aumento considerable de tráfico y una disminución del rendimiento de la red. 

Ethernet blossoms with bus, star, mesh technology. By Kevin Burak and Roland Gendreau

 
La ausencia de campos TTL (Time To Live) en la capa 2, en contraste con la capa 3,  genera un consumo adicional del ancho del banda utilizado, por lo tanto, el tráfico legítimo no dispone de suficiente ancho de banda, en muchos casos la red se satura tanto que no está en condiciones de transmitir de datos.   

La solución es dividir la red con un router para evitar este tipo de reenvío indefinido o permitir la existencia de enlaces físicos redundantes pero creando una topología lógica libre de loops con STP, ya que este protocolo permite una sola trayectoria activa entre dos dispositivos de red, esto evita los bucles pero manteniendo las rutas redundantes como reserva, para activarlos en caso de que el camino principal falle.

Inestabilidad en la tabla de direcciones MAC: 

El switch registra las direcciones MAC aprendidas y mapea también sus puertos relacionados en una tabla dinámica. Si no hay tramas provenientes de dichas direcciones en un lapso de 300 segundos, la tabla elimina la dirección MAC. En el caso de presentarse un loop, la trama puede alcanzar una dirección MAC por diferentes puertos, y el switch no puede definir a dónde enviar la trama recibida.

Retransmisión de múltiples tramas

Una misma trama puede ser transmitida desde diferentes puertos, el receptor obtiene entonces múltiples copias de la misma trama repetida, esto también genera la saturación de trafico. Las tramas broadcast no son las únicas afectados por los loops, las tramas unicast enviadas a una red con loops pueden generar tramas duplicadas que llegan al dispositivo de destino.


Si tienes información adicional sobre este tema, tus comentarios o links de referencia serán bienvenidos.

Sunday, March 04, 2012

Ejemplos resueltos sobre analisis iterativo de la complejidad de algoritmos recursivos

"Para entender la recurrencia, primero hay que entender la recurrencia"

La recurrencia se presenta cuando un proceso se define basándose en función de si misma. Esto significa que una operación compleja se puede descomponer recursivamente en términos más sencillos, entonces los resultados parciales generados por las partes mas pequeñas se usan para encontrar la solución del problema completo.

El análisis de algoritmos es fundamental para entenderlos y aplicarlos en soluciones prácticas a problemas reales. Los aspectos que mas se estudian son el tiempo que tardan en ejecutarse, el rendimiento según los recursos de computación y el comportamiento en un nuevo entorno.
 
Las funciones recurrentes presentan grandes inconvenientes debido a que su  tiempo de ejecución tiende fácilmente a valores muy grandes o a infinito, ésto puede generar problemas de desbordamiento de memoria, por lo tanto, es necesario limitar su comportamiento con valores asintótico dados por la notación de Landou o más conocida como notación O grande.


La complejidad con que se ejecuta un algoritmo depende del número de datos de entrada el cual debe ser un valor finito. La relación de recurrencia está dada de la forma:
donde a ≥ 1y b >1 ademas
  • n es numero de datos que se analizan en todo el problema.
  • a es el número de partes en que se ha dividido el problema para estudiarlo recursivamente.
  • (n/b) tamaño de cada parte en que se ha dividido el problema, asumiendo el mismo tamaño para cada una.
  • f(n) es el costo de realizar las llamadas recursivas, incluyendo el proceso de dividir y volver a unir las subtotales para obtener la solución total.
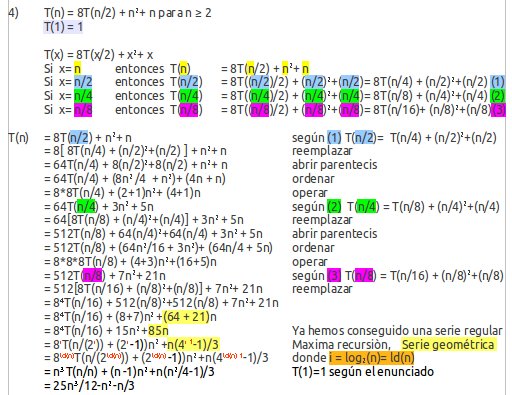
Los siguientes son 4 ejemplos de como analizar paso a paso  la complejidad del tiempo de ejecución en algoritmos recursivos:


Siguiente: Ejercicios resueltos usando  Teorema Maestro

Si tienes información adicional sobre este tema, tus comentarios o enlaces de referencia serán bienvenidos.

Tuesday, February 28, 2012

Diario de un ciberdelincuente

Muchos piratas informáticos están en el negocio para hacer transferencias bancarias ilegales, robar secretos comerciales, substraer información de Investigación y desarrollo, o obtener ventajas desleales sobre un rival, por ejemplo aplicar un ataque DoS a eBay en los últimos minutos de una subasta.


¿Que es lo que quieren los piratas informáticos? Esta es una pregunta demasiado general, porque su solución especificaría diferentes perfiles delictivos. Lo único claro es que aquel típico cliché del intruso entre 14 y 34 años de edad, adicto a la informática, sin ningún interés comercial, es una especie en vía de extinción.
Imagen de Bigstock
Hoy en día el panorama ha cambiado, algunos quieren Robar información mientras otros solo desean generar caos, sentar un precedente en señal de protesta,  o simplemente incrementar su ego al aparecer en los periódico y alardear en frente a un círculo de amigos.

Los intrusos que roban información confidencial van detrás de un bien específico. El botín puede variar desde códigos de activación de los juegos mas populares del momento, información bancaria, hasta secretos comerciales o gubernamentales. Los sistemas de gobierno poseen grandes cantidades de información personal sensible y muy valiosa, por lo que se encuentran en la categoría de alto riesgo.

En cuestiones de comerciales es muy común acosar empresas, políticos o figuras públicas modificando la información desplegada en sus páginas web oficiales, inhabilitar sistemas generando ataques de Denegación de servicio (DoS) que saturen los servidores de la competencia o simplemente robando información para obtener un beneficio personal.

Este es el caso de un estudiante anónimo de 21 años quien se hace llamar "0x80", el  requiere aproximadamente solo 2 minutos de trabajo diario para gestionar botnets y obtener Ingresos mensuales de $ 6.800 en promedio. ¿Como? Conversando con personas en los chats mientras que los bots le generan dinero [Krebs2006 ]. 

Si este suena como el trabajo de tus sueños sería bueno que revisaras cuales serían tus funciones:
  • Controlar mas de 13.000 computadores en más de 20 países.
  • Cuando los hosts infectados descargan parches, es necesario buscar nuevas víctimas
  • Desplegar publicidad de Adware y generar minería de datos de los hábitos de navegación de la víctima.
  • Mientras tanto los bots recogen contraseñas, direcciones de correo electrónico, numero de seguro social, datos bancarios y de tarjetas de crédito
  • Empresas como TopConverting.com, GammaCash.com, Loudcash o 180Solutions pagan por esta información.
http://www.microsoft.com
Interesante ¿verdad?, pero si te empeñas en empezar este estilo de vida, piénsalo muy bien, ya que algunos casos mas conocidos no han tenido finales felices. Por ejemplo Sean Smith pagó 5 años de prisión y una multa de 150.000 dolares por crear el virus Melisa (Mail-lissa), el cual fue desarrollado usando "Word" el procesador de texto de Microsoft office, este enviaba correo electrónicos masivos desde la propia cuenta del usuario a través de Outlook. Si un documento de Word que contenía el virus, ya fuera List.doc u otro archivo infectado, era descargado y abierto, se activaba la macro que lo replicaba.

Ehud Tenenbaum conocido como "The Analyzer" Irrumpió en la red del Departamento de Defensa EE.UU. Por lo que fue condenado a 6 meses de prisión y una multa de 18.000 dolares, mientras que Dmitry Sklyarov abrió el código de eBooks de Adobe y fue arrestado después de dar una conferencia titulada "Seguridad eBook - Teoría y práctica "en la convención de DEF CON en Las Vegas, Nevada. Él fue acusado de distribuir un producto diseñado para eludir las medidas de protección del copyright y arrestado por el FBI cuando se disponía a regresar a Moscú.

La confidencialidad es uno de los principales objetivos de la seguridad y se refiere a la exposición no autorizada de datos, es cuando terceros tienen acceso,  conocimiento o liberan intencionalmente información sensible de manera ilegal.

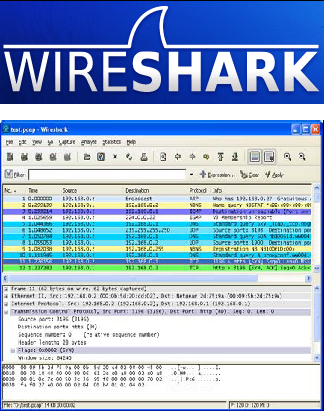
Existen dos formas de romper la confidencialidad del sistema, la primera es por intrusión no autorizada sobrepasando las protecciones de control de acceso y las políticas de seguridad del sistema. La segunda forma es la  Interceptación de paquetes y datos en transito, como correos electrónicos o interfiriendo canales de comunicación para obtener información a través de la observación de los patrones del tráfico de red con herramientas de análisis de tráfico como wireshark.

Imagen de http://blogofsysadmins.com
 En este enlace podrás descargar este interesante  Manual de análisis de tráfico con wireshark

En general los intrusos son externos, sin embargo las empresas también tienen que afrontar amenazas internas que son mucho mas difíciles de manejar debido a la relación de confianza que se genera entre las personas que trabajan en un proyecto de investigación y desarrollo. Sumado a que el nivel de habilidad necesaria para ocultar código malicioso es mucho menor que el requerido para encontrarlo, esto significa que es fácil ocultar código en grandes paquetes de software o instalar backdoors prácticamente imposibles de detectar, cualquier persona con acceso al medio desarrollo es capaz de ingresarlo.

Un ejemplo que cabe mencionar de amenazas internas es la de Rob Harris quien trabajaba en una fábrica de máquinas traga-monedas, el inyecto un código en la unidad de pruebas, para generar un algoritmo que activaba el modo ganador después de ingresar una secuencia específica de monedas, este código nunca fue detectado en el proceso de producción. Fue atrapado cuando su codicia despertó sospechas después de haber ganado mas de 100.000 dolares.

Los ejemplos expuestos anteriormente demuestran que la seguridad informática tiene aplicaciones en todos los ámbitos que rodean nuestros  entornos, desde el hogar, las compañías privadas y entidades gubernamentales, los riesgos de perder confidencialidad siempre están presentes y somos nosotros los profesionales de seguridad IT quienes debemos crear conciencia de como proteger nuestros sistemas.

Referencia: Krebs2006 : Krebs, B., Invasion of the Computer Snatchers, 2006
Mas información en: Seguridad IT III: La biodiversidad en el ecosistema de las vulnerabilidades

Si tienes información adicional sobre este tema, tus comentarios o links de referencia serán bienvenidos.

Monday, February 27, 2012

Seguridad IT III: La biodiversidad en el ecosistema de las vulnerabilidades

En la actualidad se ha vuelto recurrente escuchar de empresas cuyos sistemas han sido blanco de incidentes de seguridad. Cada día se lanzan millones de ataques criminales a equipos personales, corporativos y gubernamentales, este es uno de los grandes problemas que las mesas directivas tienen que resolver de manera prioritaria, armándose con un equipo de expertos en seguridad para proteger su información y creando una conciencia organizacional de la importancia de salvaguardar la información, mas ahora que esta tiene un precio,si no están lidiando con estos temas, lo hacen bajo su propio riesgo. Los recortes presupuéstales generan problemas para el personal de seguridad y un beneficio para los ciberdelincuentes.

 
Cada vez que nace un nuevo hito tecnológico surge una nueva amenaza, Cualquier aplicación Web debe estar desarrollada siguiendo estrictos controles de seguridad, las aplicaciones de redes sociales ya son blancos de ataques que aprovechan las relaciones de confianza entre amigos en línea para esparcir código malicioso, la visualización y Cloud Computing tan de moda en estos días se han hecho objetivos prioritarios de ataques de día cero, teniendo en cuenta que aún son tecnologías en desarrollo con posibles agujeros por descubrir.


Un ataque de día cero es una amenaza informática que trata de explotar las vulnerabilidades de software que son desconocidas por los propios desarrolladores del producto tecnológico. Aplicaciones como Google, Excel, Word, Powerpoint y muchas mas, han sido víctimas de estos agujeros de seguridad. El término deriva del momento en que se dio el insidente, el "día cero" en que ocurre el ataque y se toma conciencia de su existencia, el desarrollador no ha tenido la oportunidad de distribuir una solución de seguridad para los usuarios del software.

Otro peligro inminente son los dispositivos que han sido perdidos o robados como portátiles, memorias USB, teléfonos móviles y demás medios de almacenamiento, los cuales almacenan contienen información sensible y secretos industriales des propietarios, sumando también los computadores de segunda mano en especial los discos duros son fuentes inagotables de información que presentan un riesgo de fuga de información estando ahora en manos criminales son acceso limitado a estos datos.
Para aprender como proteger y prevenir un sistema de información de vulnerabilidades, ataques y malware, es necesario conocer los diferentes tipos de exploits. Se recomienda limitar su uso en sistemas diseñados exclusivamente para hacer pruebas controladas (sandboxes), ya que podrían causar causar graves daños en sistemas reales, así que es importante utilizar este conocimiento de forma responsable, con propósitos informativos y nunca en contra de algún usuario u organización [Stallin2008].


Malware, worms (gusanos) y troyanos se difunden a través de mensajería instantánea y correos electrónicos con imágenes, videos, y diapositivas, que solicitan su reenvío or medio de cadenas a mas contactos como requisito indispensable para que se cumpla algún buen propósito.

Fraudes como La carta Nigeriana (o estafa 419) aun siguen teniendo éxito, esta es una estafa en la que se convence a la víctima de pagar por adelantado alguna suma de dinero con la esperanza de realizar una ganancia significativamente mayor. Sin embargo esta no es la única tendencia de distribución de estos ataques, los ampliamente utilizados Blogs son otra alternativa, hay mas de 184 millones de blogs en todo el mundo, aproximadamente el 73% de los internautas han leído un blog de los cuales 50% han dejado comentarios posteriores, algunos blogs tienen enlaces automatizados que facilitan las referencias cruzadas y son fácilmente explotados por spammers.

Referencia:
Stoneburner2001: Stoneburner, G., Underlying Technical Models for IT Security, 2001
Stallin2008: Stallin, W., Computer Security: principles and Practice, 2008

Si tienes información adicional sobre este tema, tus comentarios o links de referencia serán bienvenidos.